
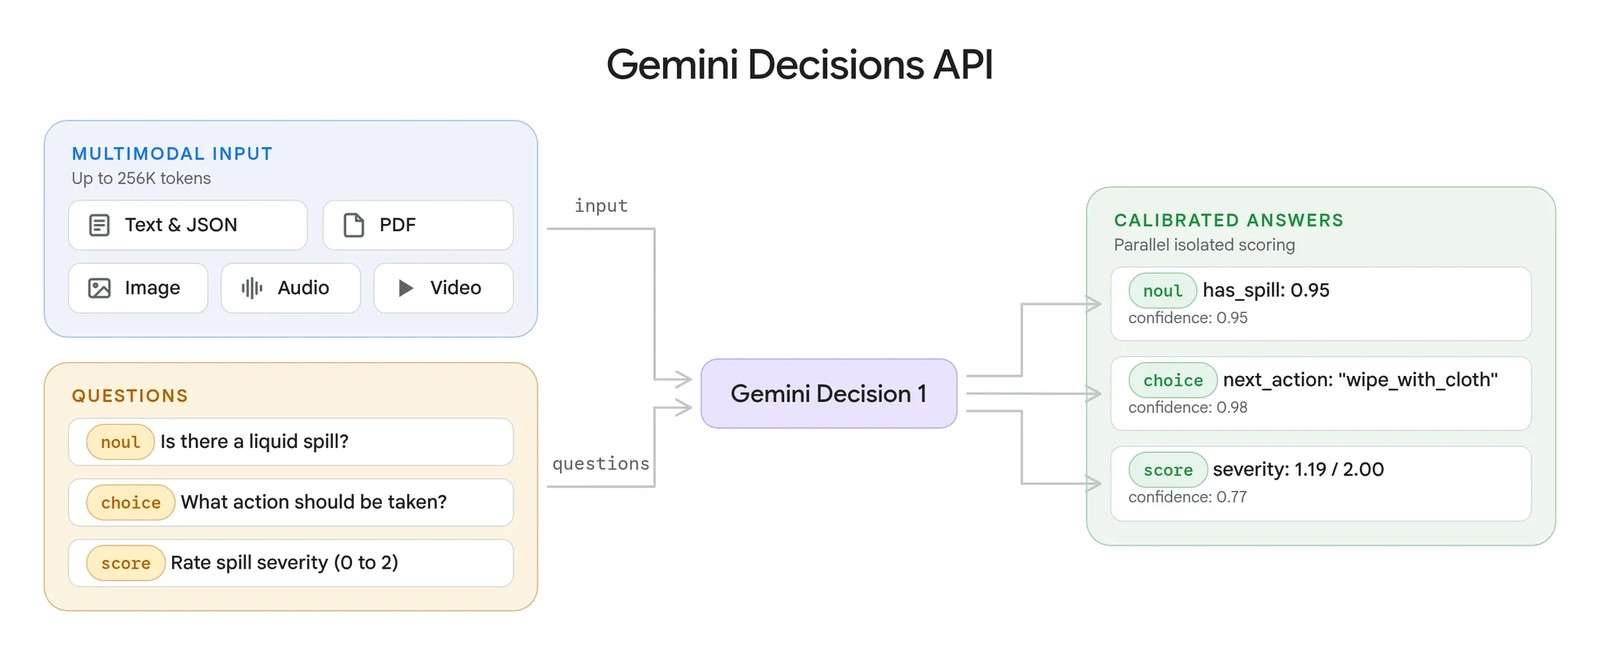
11 ноября Google выпустила модель решений Gemini Decision 1 (gemini-decision-1) и новый эндпоинт Decisions API в Gemini API и Google AI Studio. Текста модель не генерирует: на типизированные вопросы «да или нет», «какой из вариантов», «какой уровень по рубрике» она возвращает калиброванные вероятности, и код ветвится по ним напрямую. Там, где LLM просили вернуть JSON и потом разбирали ответ, остаётся один вызов без выходных токенов.
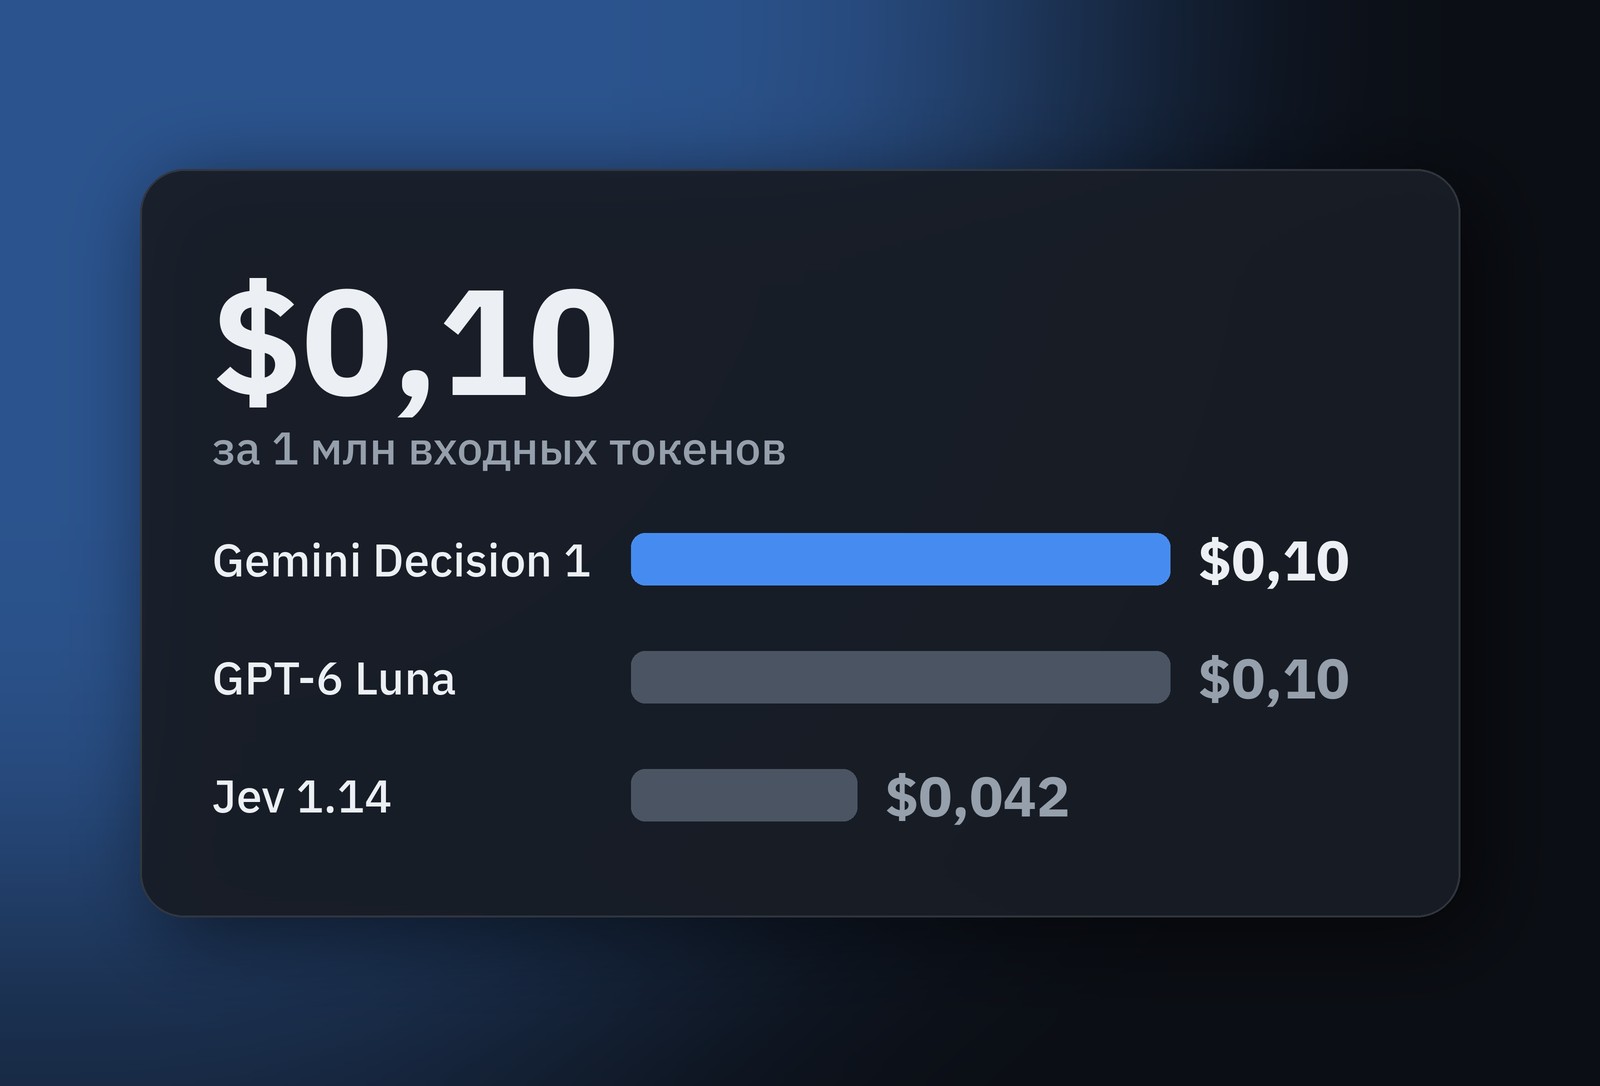
В запрос помещается до 1000 вопросов к общему входу: тексту, изображениям, аудио, видео или PDF в пределах 262 144 токенов. Миллион входных токенов стоит $0,10, выход не тарифицируется, есть бесплатный уровень. Кеширования и Batch API нет, а Россия в список регионов Gemini API не входит. Все результаты тестов ниже получены самой Google, независимых замеров на день запуска нет.
Ключевые выводы
- Три типа вопросов:
noul(да или нет, вероятность от 0,01 до 0,99),choice(выбор из 2–255 вариантов) иscore(рубрика из 2–255 уровней); общий вход оплачивается один раз на запрос. - Бесплатный уровень: до 200 запросов и 50 000 токенов в минуту, до 10 000 запросов в день на проект; по таблице тарифов его данные Google использует для улучшения продуктов.
- По замерам Google, модель обходит и Jev 1.14, и GPT-6 Luna в 5 из 7 общих тестов, ошибка калибровки Top-1 ECE 0,0250 против 0,0494 и 0,0721. Прогон семи тестов дешевле у Jev: $0,68 против $0,88.
- Google заявляет медианную задержку полного запроса 150–250 мс для контекстов до 16 тыс. токенов и от 1 до 100 вопросов.
- Поддержку в Google Cloud обещают «скоро» без даты; на OpenRouter модель уже доступна по идентификатору
google/gemini-decision-1.
Когда модель решений заменяет вызов LLM с разбором ответа?
Когда коду нужен один из заранее известных исходов и число, по которому ставят порог. Документация Decisions API относит сюда роутинг запроса в модель, очередь, агента или инструмент, проверку входа и выхода сразу по многим правилам, выбор инструментов для агента, ранжирование кандидатов по рубрике и реакцию на аудио и кадры видео в реальном времени. За генеративным Interactions API остаются текст и объяснения, извлечение значений по своей JSON-схеме, вызовы инструментов с аргументами и многошаговые рассуждения.
| Задача | Тип вопроса | На что смотреть в ответе |
| Проверка одного условия: есть ли в сообщении жалоба на дефект | noul |
noul, вероятность ответа «да»; порог подбирают на своих размеченных примерах |
| Роутинг обращения, выбор модели или инструмента | choice |
choice и confidence; при низкой уверенности запрос уходит человеку |
| Оценка серьёзности или релевантности по рубрике | score |
score вместе с probabilities: одинаковый балл дают разные распределения |
| Проверка фото, записи звонка или видео | любой, медиа передаётся в input |
usage.input_tokens_by_modality: кадры видео и страницы PDF считаются токенами изображений |
Что возвращают три типа вопросов?
Значение и confidence, оценку вероятности того, что главный ответ верен. В примере из документации к обращению клиента (данные заказа и текст жалобы на наушники) задают три вопроса разных типов. Фрагмент запроса на Python:
        questions={
    "is_defect": {
        "type": "noul",
        "instructions": "Does `message` describe a hardware defect?",
    },
    "next_action": {
        "type": "choice",
        "instructions": "What is the right resolution given `tier` and `order`?",
        "criteria": {
            "instant_refund": "Refund without return. Low value or clear fault.",
            "replacement_shipment": "Ship a replacement. Customer returns the original.",
            "troubleshooting_flow": "The issue may be fixable by the customer.",
            "human_escalation": "",
        },
    },
    "churn_risk": {
        "type": "score",
        "instructions": "How likely is the customer to churn if the issue is not resolved now?",
        "criteria": [
            "No churn signal",
            "Mild frustration",
            "Mentions alternatives",
            "Threatens to cancel",
        ],
    },
},
Поле answers из ответа:
        "answers": {
  "is_defect": { "type": "noul", "noul": 0.94, "confidence": 0.94 },
  "next_action": {
    "type": "choice",
    "choice": "human_escalation",
    "probabilities": {
      "human_escalation": 0.76,
      "replacement_shipment": 0.18,
      "troubleshooting_flow": 0.04,
      "instant_refund": 0.02
    },
    "confidence": 0.76
  },
  "churn_risk": {
    "type": "score",
    "score": 2.99,
    "legend": {
      "0": "No churn signal",
      "1": "Mild frustration",
      "2": "Mentions alternatives",
      "3": "Threatens to cancel"
    },
    "probabilities": { "0": 0.0, "1": 0.0, "2": 0.01, "3": 0.99 },
    "confidence": 0.99
  }
}
noulвозвращает вероятность ответа «да», здесь 0,94;confidenceдля него равнаmax(noul, 1 - noul). Двусмысленный вопрос уточняют полямиtrue_descriptionиfalse_descriptionвcriteria.choiceвозвращает победивший вариант и вероятности всех вариантов, в сумме равные 1.confidenceсовпадает с вероятностью победителя: 0,76 уhuman_escalation.scoreвозвращает взвешенное по вероятностям среднее индексов уровней, считая с нуля, поэтому балл бывает дробным: 2,99 при уровнях от 0 до 3. Когда нужен дискретный уровень, документация советует брать уровень с наибольшей вероятностью.
Запрос занял 324 входных токена. Код примера берёт вариант модели в переменную action, только если вероятность дефекта выше 0,9 и уверенность в выборе выше 0,6; иначе в action записывается human_escalation, передача человеку.
Какие ловушки называет сама Google?
Почти все связаны с порогами и с тем, что модель отвечает на любой вопрос, даже неуместный:
- Вероятность в
noulвсегда лежит между 0,01 и 0,99. Условиеnoul > 0.99не сработает никогда. choiceраспределяет вероятность по вариантам, даже когда не подходит ни один. Защиты три: порог поconfidence, отдельный вопросnoulо том, относится ли вход к теме, или вариант-заглушка с явным описанием. Ключи сортируются по алфавиту, поэтому заглушку называютother: имяnone_of_the_aboveне гарантирует последнего места и окажется раньшеshippingиtechnical.scoreусредняет индексы 0, 1, 2 и дальше, поэтому экспоненциальные шкалы вида 1, 10, 100, 1000 искажают балл.- Вопросы не видят ни друг друга, ни своих ключей: полный текст вопроса пишут в
instructions, зависимые решения оформляют вторым запросом либо задают оба вопроса сразу и игнорируют лишний ответ. - Вход считают недоверенным: «User-supplied text can argue for its own classification» (текст пользователя может уговаривать классификатор в свою пользу; перевод Proglib). Для выплат и других дорогих действий Google советует оставлять человека или вторую проверку.
- Если запрос блокируют фильтры безопасности, вместо
answersприходит HTTP 400 с кодом вродеsafetyилиcontent_blocked. Эту ветку обрабатывают отдельно от ответа «нет». - Кеширования контекста, Batch API, Flex и Priority нет: повторяющийся вход каждый раз оплачивается полностью. Историю диалога передают только текстом.
Где Google уже применяет Decisions API и что показывают её замеры?
В анонсе названы четыре сценария: выбор инструмента, проверка политик, роутинг моделей и оценка контекста. О внутренних применениях авторы пишут так:
Teams across Google are already using the Decisions API as a low-latency control plane, shipping features simply by defining options rather than training custom classifiers or waiting on generative calls.
Gemini Notebook направляет запросы на подходящий уровень модели и размышлений; по словам Google, повседневные запросы обслуживаются с задержкой до 40% ниже. CC из Google Labs выбирает эмодзи-реакцию из палитры больше чем в 200 вариантов. Google Search проверяет моделью MCP-инструменты на враждебное поведение; чисел для этого примера компания не приводит.
В таблице бенчмарков Google сравнивает модель с TypeSafe Jev 1.14, GPT-6 Luna через OpenAI Decisions API и своей генеративной Gemini 3.5 Flash-Lite. Из семи тестов, где есть результаты всех моделей, Gemini Decision 1 обходит обоих конкурентов в пяти: JevBench (92,2%), Amazon ESCI (58,7%, метрика Macro-F1), New Yorker Caption (79,7%), PubMedQA (79,8%) и Global-MMLU-Lite (86,0%). Jev впереди на Mind2Web Multimodal (86,8% против 86,2%) и When2Call (82,0% против 79,9%). Аудиотест MMAU и видеотест Video-MME Google прогоняла только на своих моделях.
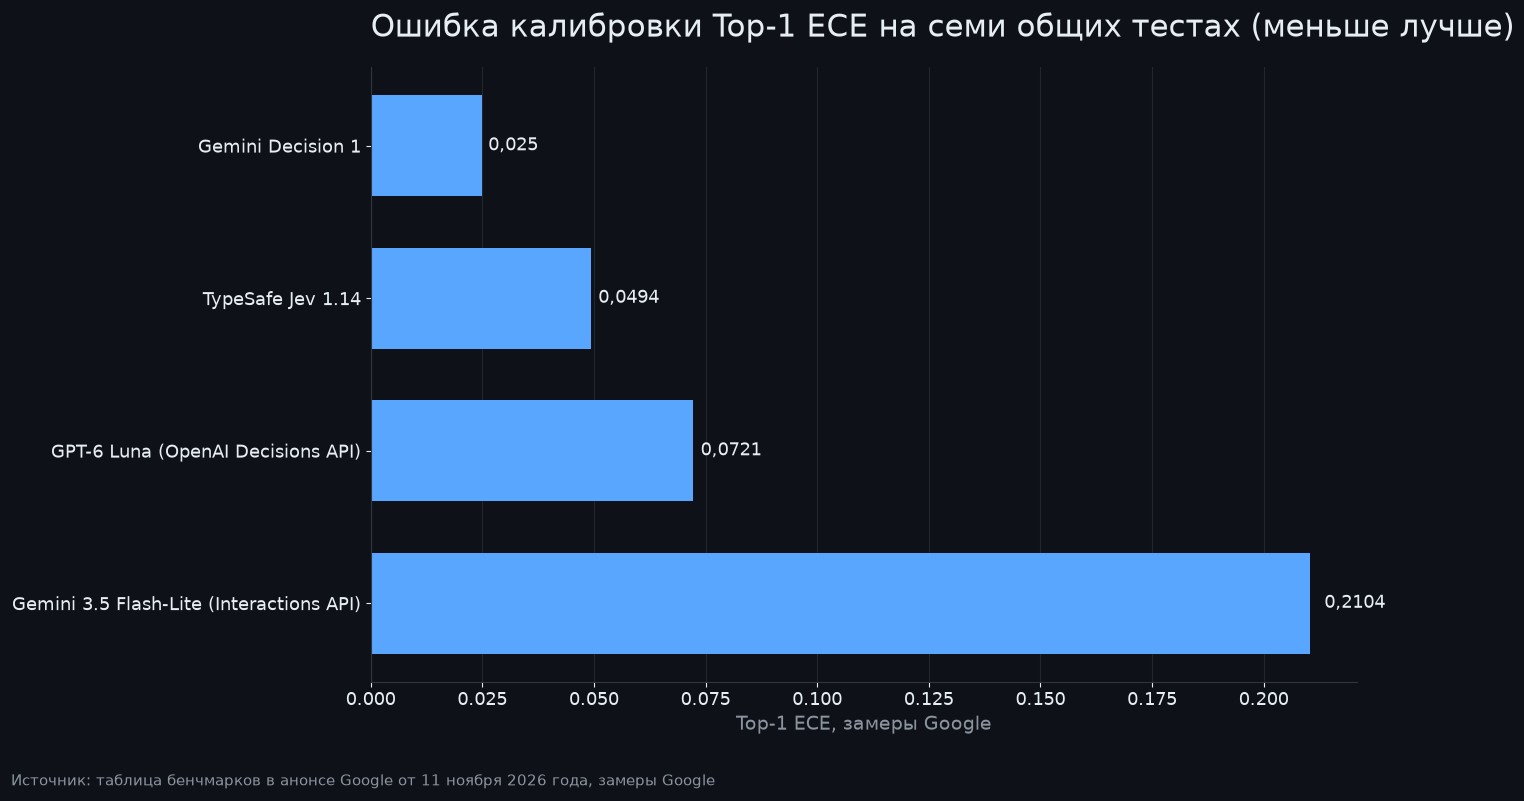
Top-1 ECE показывает, насколько заявленная уверенность расходится с фактической долей верных ответов. На этих семи тестах расхождение у Gemini Decision 1 наименьшее; на ваших данных калибровка может оказаться другой. О подсчёте результатов известно из одной сноски: отказы, блокировки фильтрами и запросы, которые модель не смогла принять, засчитаны как неверные ответы, знаменатель всегда полный набор теста. Как считалась и сводилась по семи тестам сама ECE, Google не раскрывает.
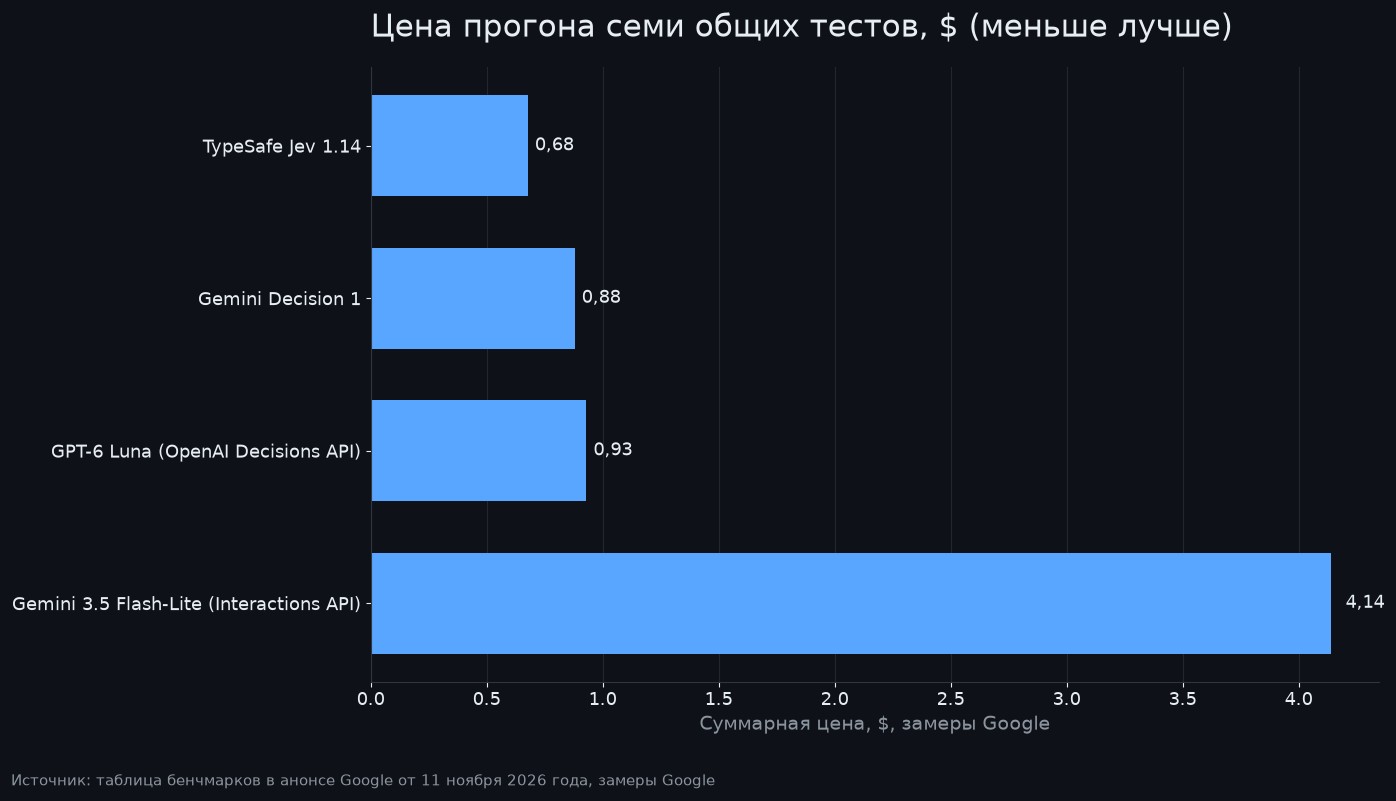
Прогон у Jev дешевле: $0,68 против $0,88 у Gemini Decision 1 и $0,93 у GPT-6 Luna. Генеративная Gemini 3.5 Flash-Lite обошлась в $4,14, в 4,7 раза дороже, и уступила на всех девяти тестах. Сотрудник Google Логан Килпатрик, работающий над Gemini API и AI Studio, назвал новинку «frontier decision model»; по таблице его же компании она уступает Jev в двух тестах и по цене прогона.
Сколько стоит запрос и на что хватит бесплатного уровня?
Число входных токенов умножается на $0,10 за миллион. Запрос из примера выше занимает 324 токена, значит миллион таких обращений стоит 324 млн токенов x $0,10 / 1 млн = $32,40. У Jev по цене из документации TypeSafe, $0,042 за миллион, тот же объём стоил бы $13,61; это оценка, потому что модели считают токены по-разному.
На бесплатном уровне для запросов по 324 токена первым сработает лимит токенов: 50 000 / 324 = 154 запроса в минуту вместо 200.
Объединение вопросов экономит больше, чем выбор поставщика. Допустим, документ занимает 10 000 токенов и его проверяют по 50 правилам, по 40 токенов на вопрос. Один запрос: 10 000 + 50 x 40 = 12 000 токенов, или $0,0012. Пятьдесят отдельных запросов: 50 x (10 000 + 40) = 502 000 токенов, или $0,0502, примерно в 42 раза дороже. Кеша нет, поэтому каждый новый запрос с тем же документом оплачивает его заново.
Чем Gemini Decision отличается от OpenAI Decisions API и Jev?
Модальностями, лимитами и ценой. Типы вопросов почти одинаковые, а названия noul, choice и score у Google совпадают с названиями у Jev. Сравнение по документации трёх сервисов:
| Gemini Decision 1 | OpenAI Decisions API (GPT-6 Luna) | TypeSafe Jev 1.14 | |
| Вход | текст, изображения, аудио, видео, PDF | текст, изображения, JSON; файлы и аудио не поддерживаются | текст, изображения PNG и JPEG; аудио и видео не принимает |
| Типы вопросов | noul, choice, score | predicate, choice, score | noul, choice, score, box (рамка на изображении) |
| Вопросов на запрос | до 1000 | до 400 | отдельного лимита нет |
| Контекст | 262 144 токена | в руководстве не указан | 64 тыс. токенов на запрос, 32 тыс. на вопрос; 262 тыс. с отдельным заголовком |
| Цена входа за 1 млн токенов | $0,10 | $0,10 без кеша | $0,042 |
| Кеширование входа | нет | есть, префикс от 1024 токенов | на странице моделей не описано |
Аудио, видео и PDF на входе из трёх сервисов принимает только Google. У OpenAI, судя по руководству Decisions API, есть кеширование и передача истории диалога с вызовами инструментов. Jev дешевле всех по цене токена, но изображения включаются отдельным заголовком, и TypeSafe прямо пишет, что они пока не готовы для продакшена. Пользователь waximabbax в обсуждении анонса на Hacker News подытожил: модель «bit more expensive», зато «can accept Audio and Video as input as well» (немного дороже, но принимает ещё и аудио с видео).
Как попробовать Decisions API?
Нужен ключ Google AI Studio; для SDK подойдёт google-genai версии 3.2 или новее (pip install -U google-genai). Минимальный запрос из документации обходится без SDK:
        curl -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-decision-1",
    "input": "The blue mug I ordered on Monday arrived cracked on Wednesday.",
    "questions": {
      "is_damaged": {
        "type": "noul",
        "instructions": "Did the item arrive damaged?"
      }
    }
  }'
В ответе придёт answers с вероятностью ("noul": 0.99 в примере документации) и usage, где total_output_tokens всегда равен 0.
- Вопросы и пороги удобно подбирать в Decisions Playground в AI Studio: он работает с текстом и медиа и выгружает готовый код.
- Пороги документация советует ставить по размеченным примерам из собственного трафика, взвешивая цену ложного срабатывания против цены пропуска.
- На OpenRouter, который недавно пополнился моделями для кода, RAG и голоса, модель доступна по идентификатору google/gemini-decision-1 через провайдера Google AI Studio: $0,10 за миллион входных токенов, контекст 262 144 токена. Вызывают её через Decisions API OpenRouter, SDK для chat completions с ней не работают. В общем списке моделей API на 23:42 мск 11 ноября её не было.
- Россия в список поддерживаемых регионов не входит, а условия Gemini API разрешают обращаться к сервису только из доступных регионов.
Без собственного набора проверочных примеров переносить решения на такую модель рискованно:
Anyone using a decision model like this is going to have to spin up their own evals - these are far harder to vibe-check than regular text output LLMs.
OpenAI открыла публичную бету своего Decisions API 6 октября и с тех пор перевела его в общий доступ; Google вышла в этот класс на следующий день после того, как открыла разработчикам Gemini 4 Carbon. Дальше стоит ждать даты появления в Google Cloud и первых независимых замеров калибровки, на которой построено главное заявление Google.
Источники
- https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- https://ai.google.dev/gemini-api/docs/decisions-api
- https://ai.google.dev/gemini-api/docs/models/gemini-decision-1
- https://ai.google.dev/gemini-api/docs/pricing#gemini-decision
- https://ai.google.dev/gemini-api/docs/rate-limits#gemini-decision
- https://ai.google.dev/gemini-api/docs/available-regions
- https://ai.google.dev/gemini-api/terms
- https://x.com/OfficialLoganK/status/2120581433639198885
- https://developers.openai.com/api/docs/guides/decisions
- https://docs.typesafe.ai/models
- https://docs.typesafe.ai/images
- https://openrouter.ai/google/gemini-decision-1
- https://openrouter.ai/api/v1/models
- https://news.ycombinator.com/item?id=50456791
- https://news.ycombinator.com/item?id=49984025
Комментарии