
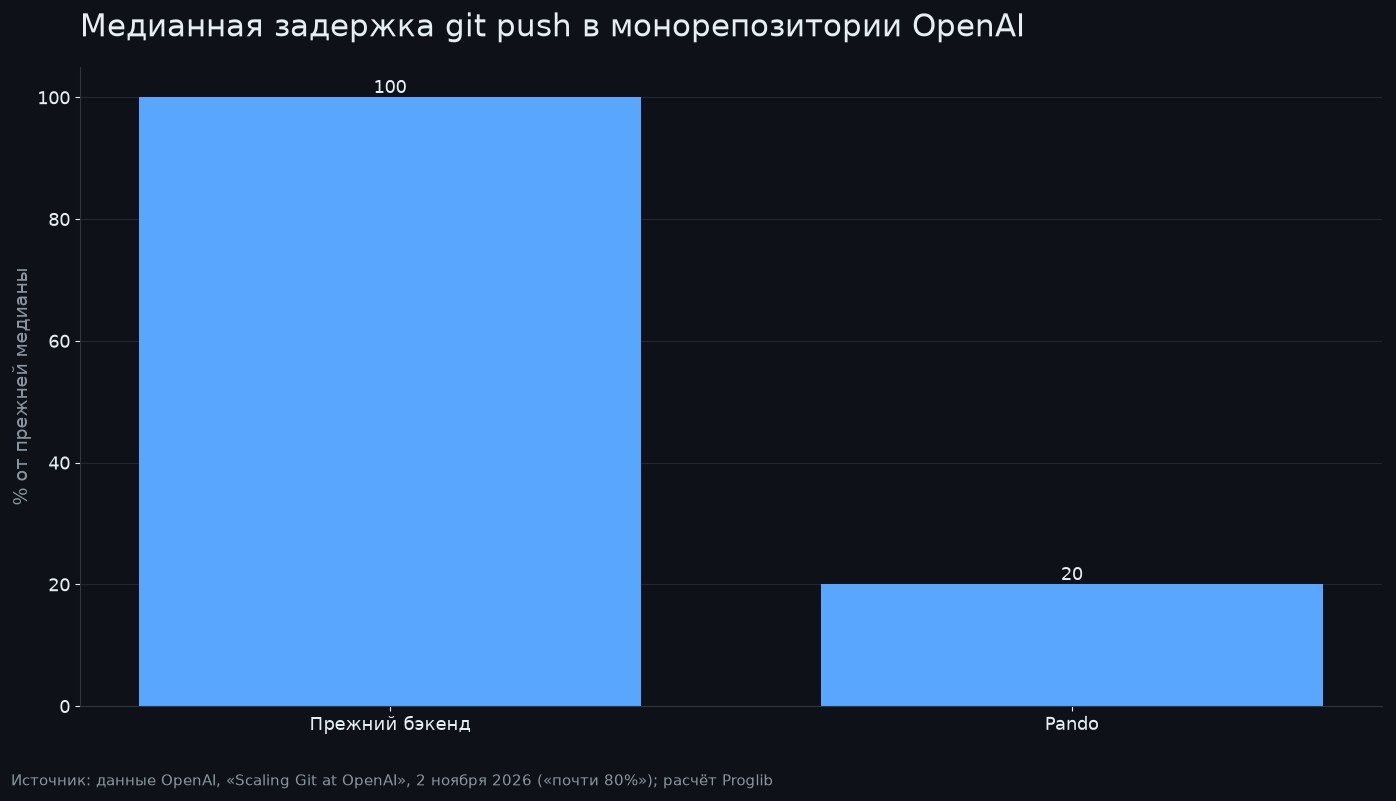
OpenAI 2 ноября 2026 года рассказала о Pando — новом серверном бэкенде для своего монорепозитория. Система написана на Rust, начала принимать продакшен-трафик в апреле 2026 года и теперь, по словам OpenAI, обслуживает всю разработку в её монорепозитории; медианную задержку push она, по данным компании, сократила почти на 80%, то есть примерно в 5 раз. Инженеры и агенты Codex при этом сохранили привычный рабочий процесс и совместимость с Git, хотя для оптимальной работы OpenAI распространяет собственную сборку клиента.
Повод для переделки — Codex. Агенты создают больше веток, чаще делают push, merge и fetch из окружений разработки, исследовательских задач и CI. К концу 2025 года прежняя система, по словам авторов, перестала справляться: fetch и push тормозили, merge падали, надёжность временами опускалась ниже 90%.
- Pando — бэкенд, а не замена Git: протокол и клиент совместимы, а правки клиента OpenAI отправляет в апстрим.
- По данным OpenAI, медианный push стал быстрее почти на 80%; система отдаёт почти петабайт данных Git в сутки, пик — больше 57 ТБ за час, свыше 99% байт из локального кэша.
- При push новой ветки сервер объявляет клиенту только основную ветку: медианный packfile меньше 20 КиБ, 99-й процентиль меньше 3 МиБ.
- OpenAI рассказывает, что ядро спроектировал один инженер, реализовали команды агентов Codex, а от старта до продакшена прошло 10 недель.
- Публичного релиза нет: OpenAI говорит, что «изучает способы поделиться технологией».
Обычный сервер Git показывает клиенту все ветки сразу
Чтобы понять, что именно сломалось, достаточно вспомнить, как устроен push. Клиент собирает packfile — сжатый набор объектов, которых, по его мнению, нет на сервере. Чтобы узнать, что на сервере уже есть, он получает от него список всех веток и тегов. Авторы Pando сравнивают это с игроком в покер, который выкладывает на стол все карты.
В монорепозитории с миллионами веток одно такое объявление может весить больше 100 МиБ. Чтобы его выдавать, каждый сервер должен держать актуальную карту всех ссылок или делать запрос к базе, который растёт вместе с числом веток. Второй источник нагрузки — fetch: для каждого клиента сервер вычисляет разницу между тем, что у клиента есть, и тем, что он просит, и упаковывает её заново. Такие ответы почти не кэшируются.
OpenAI рассматривала два привычных способа масштабирования. Первый — трёхфазный коммит между репликами, где push подтверждает большинство копий репозитория; ссылки при этом обновляются по одной, а задержка дисков и сети реплик попадает прямо в путь push. Второй — общий журнал в объектном хранилище, где каждый push обновляет единый манифест через compare-and-swap; даже push в несвязанные ветки конкурируют за одну запись. Обе схемы, по оценке авторов, упираются в одну точку координации.
Pando отказывается от единого снимка репозитория
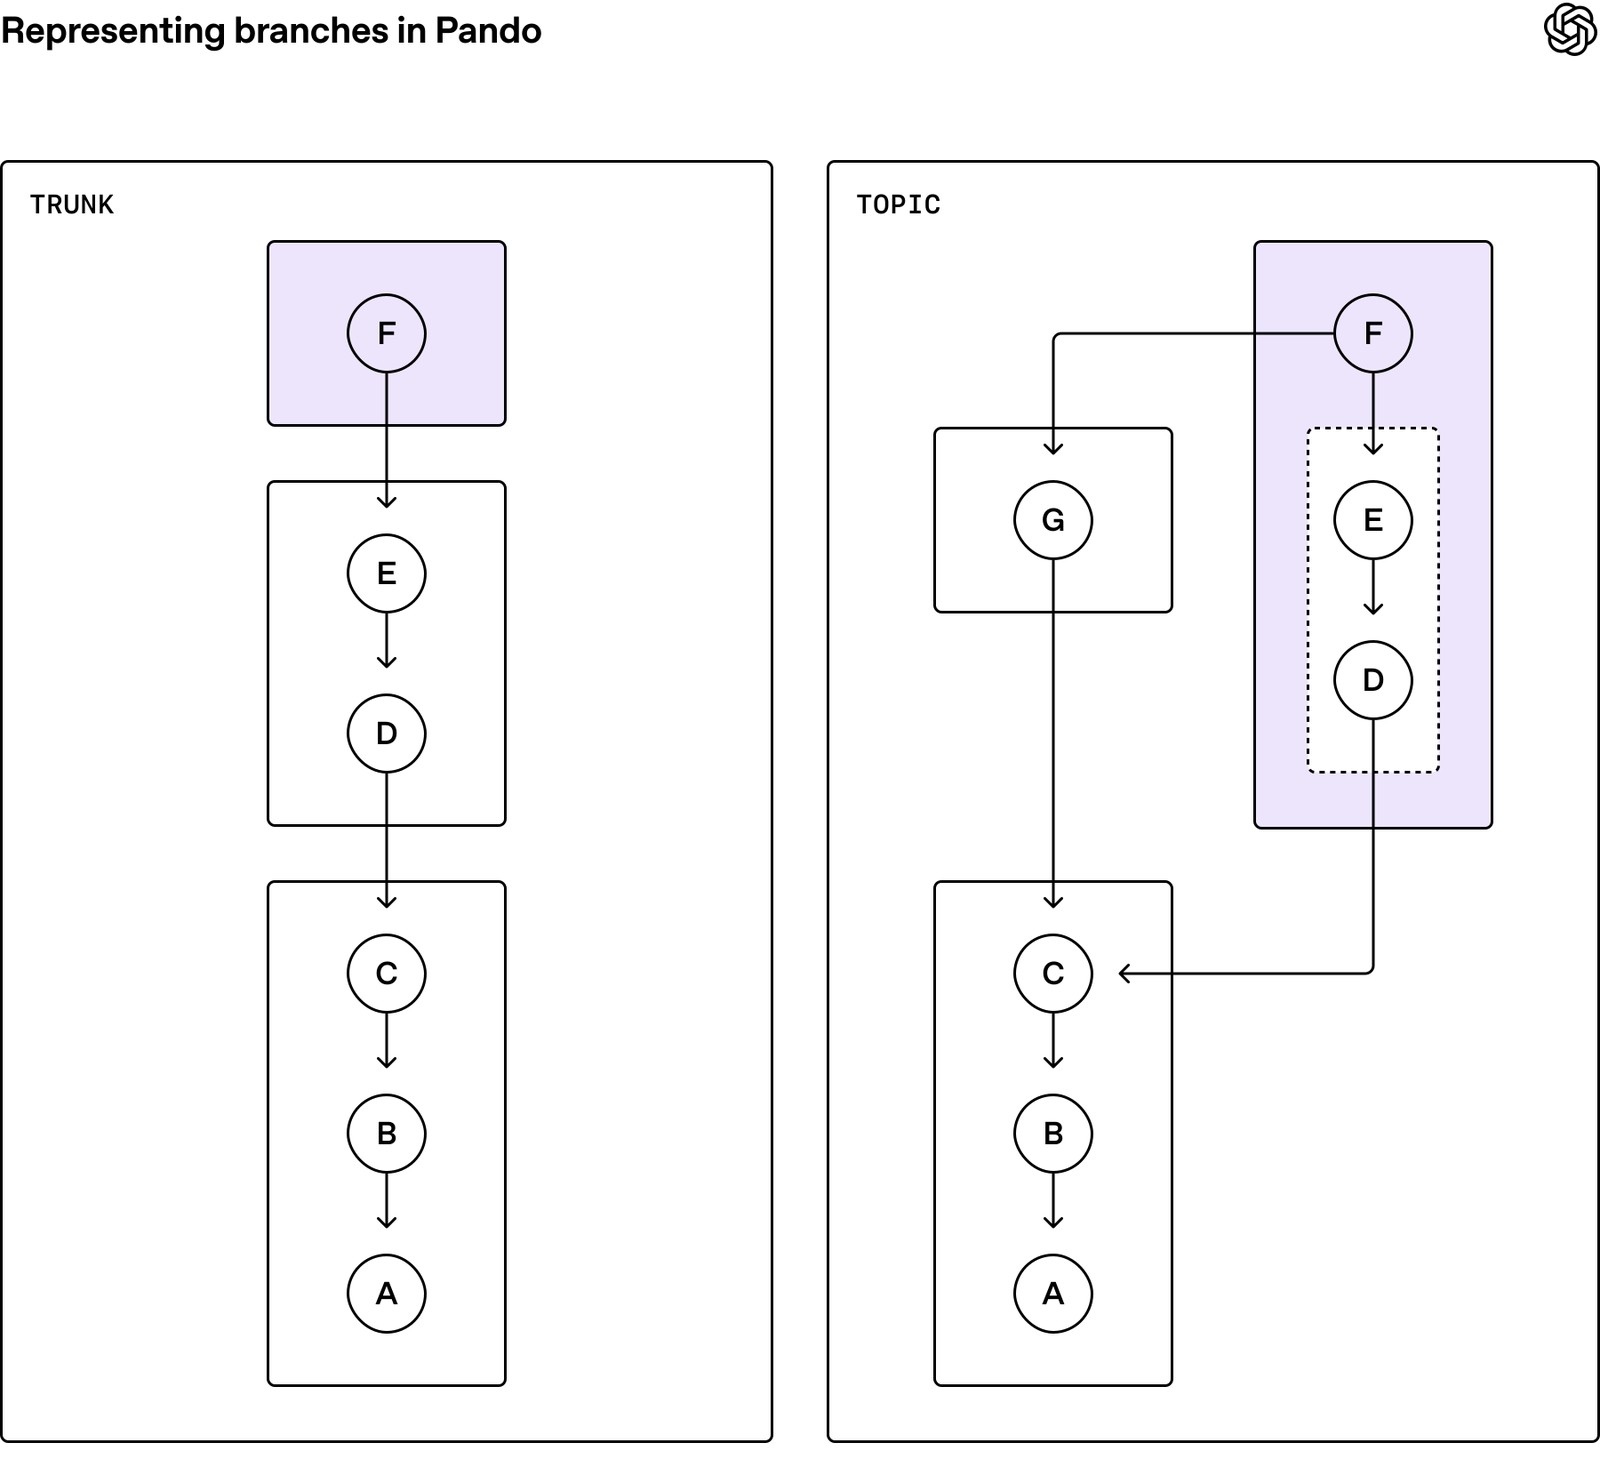
Ключевое решение — ослабить согласованность. Pando не обещает, что в любой момент времени существует единый снимок всех ссылок репозитория. Вместо этого каждая ветка обновляется независимо: при push сервер сохраняет packfile как неизменяемый объект в blob-хранилище и записывает в горизонтально масштабируемое хранилище метаданных «версию ссылки» — новый tip, пакет, который его принёс, и версии, от которых этот пакет зависит.
Авторы называют это причинной согласованностью: читатель, который запрашивает ветку, видит историю того, кто её записал. Для одной ссылки обновления сериализуются, а конфликтуют только клиенты, которые одновременно двигают одну и ту же ветку. Цена — клиент, читающий несколько веток, может увидеть их в разные моменты времени. По словам OpenAI, на практике ни людям, ни агентам глобальный порядок обновлений не нужен.
Push обходится константным числом операций с метаданными, fetch — логарифмическим от расстояния в версиях ссылки между тем, что у клиента есть, и тем, что он хочет. Сервер не распаковывает входящие пакеты в локальный репозиторий: он проверяет packfile за один проход, пока тот течёт в хранилище. На fetch сервер подбирает уже сохранённые пакеты и отдаёт клиенту ссылки на них через механизм packfile-uri протокола Git, а сами байты раздаёт сервис Express с региональными кэшами. Попадание в кэш, по данным компании, выше 99%, а clone и fetch на обычных облачных виртуалках забивают канал 10 Гбит/с.
Клиенту показывают одну ветку вместо миллионов
Чем больше ссылок объявляет сервер, тем меньше packfile, но тем сложнее этот пакет переиспользовать: другому клиенту могут не хватить объектов, которые первый не стал отправлять. Если не объявлять ничего, клиент пришлёт всю историю. Pando по умолчанию объявляет при push новой ветки только trunk. Размер объявления перестаёт зависеть от числа веток, а пакет, собранный одним клиентом, можно без изменений отдать любому, у кого есть история trunk.
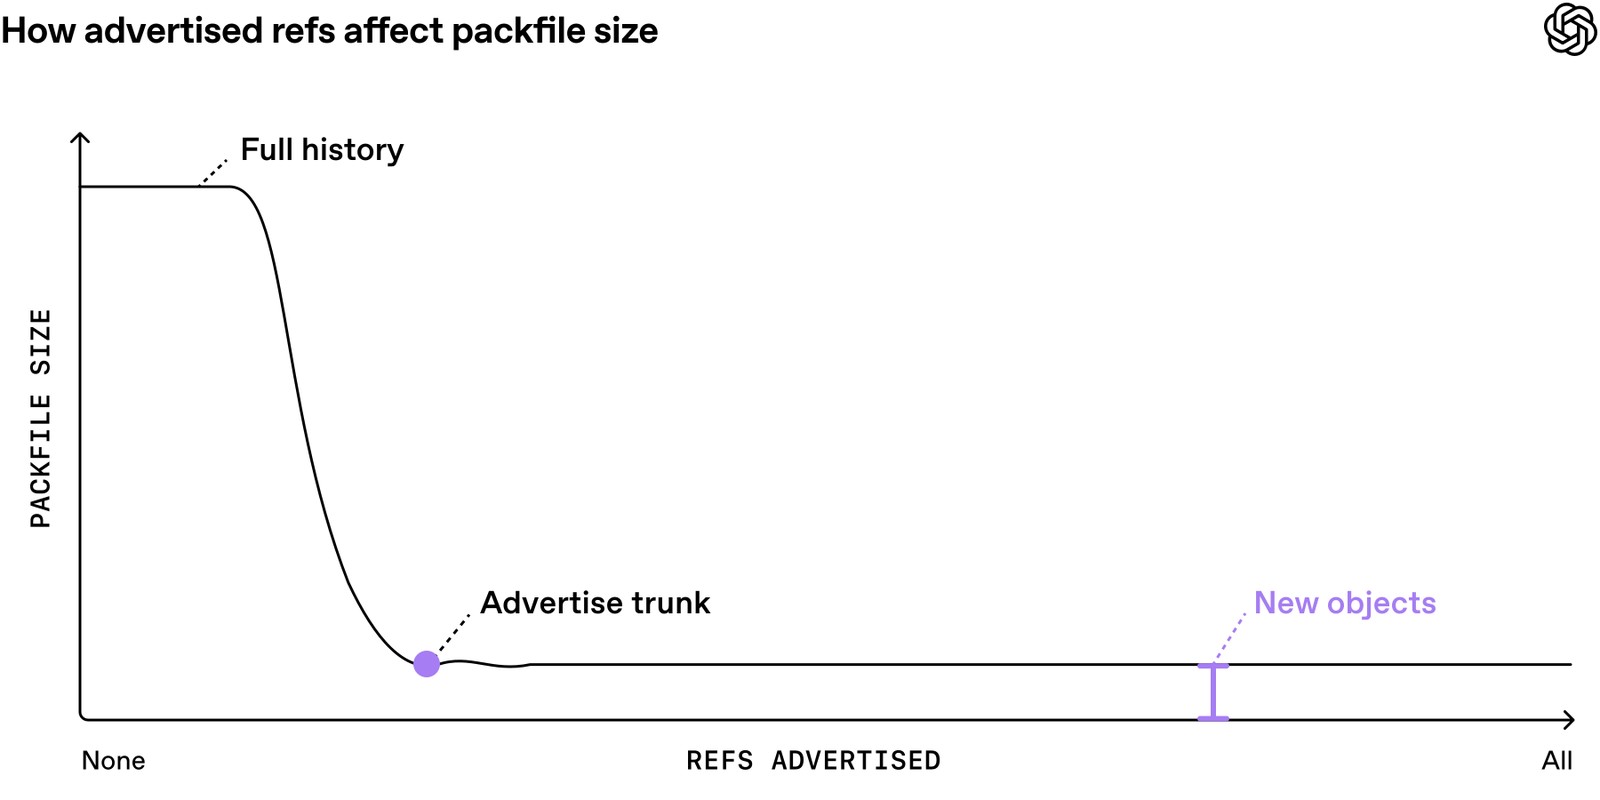
У подхода есть обратная сторона: при повторных push в одну ветку или при стеке веток клиент пересылает всё, что лежит вне trunk. В монорепозитории OpenAI медианный packfile при этом меньше 20 КиБ, а 99-й процентиль меньше 3 МиБ — компания считает такой размен выгодным.
Чтобы клиенту не приходилось скачивать десятки тысяч мелких пакетов за день, фоновые воркеры объединяют их по уровням — по аналогии с компактификацией в LSM-деревьях. Каждый push даёт пакет уровня L0, сейчас монорепозиторий использует уровни до L4. Пакеты всех уровней остаются на месте и не удаляются сборщиком мусора, а индексы по уровням работают как skip list и позволяют подобрать набор пакетов для fetch за логарифмическое время.
OpenAI утверждает, что систему построили агенты Codex за 10 недель
По словам OpenAI, Pando прошёл путь от старта до продакшена за 10 недель: ядро спроектировал один инженер, реализовали команды агентов Codex, а в эксплуатацию вывели несколько инженеров. Проект с нуля написан на Rust без унаследованных зависимостей. Для агентов подготовили набор тестов на соответствие стандартному поведению Git и детерминированную симуляцию, которая ловила гонки в согласовании и планировании пакетов.
Компания утверждает, что агенты на модели GPT-6 Astra описали «теорию Pando» на Lean и TLA+ и с её помощью находили и чинили ошибки, а отдельные сессии поиска крайних случаев шли сотни часов. Независимых подтверждений этих цифр нет — это заявление самой OpenAI.
Переезд шёл без остановки работы. Сначала Pando работал как сквозной прокси перед старой системой, попутно объединяя одинаковые запросы, затем клиентов переводили поэтапно через внутреннюю обёртку над Git CLI. Вместе с трафиком Git пришлось переносить сотни интеграций, завязанных на старые API, вебхуки и выгрузки репозитория. Свою сборку Git компания теперь ставит на машины разработчиков и внутрь десктопного ChatGPT.
Правки Git ушли в апстрим, а сам Pando пока закрыт
Совместимость с Git была осознанным выбором: OpenAI хотела, чтобы улучшения клиента пригодились не только ей. Работа над Pando вскрыла крайние случаи в параллельных загрузках пакетов, уборке после прерванных передач и возобновлении уже завершённых загрузок. Исправления этих путей компания отправила в проект Git вместе с трассировкой загрузок по packfile-uri; часть улучшений уже вошла в Git, другие, включая параллельную загрузку и индексирование пакетов, пока доступны только в публичной сборке Git от OpenAI.
Отдельное новшество — «явные haves»: сервер может объявить текущий tip ветки отдельно от истории, которую клиент вправе не включать в пакет. Это позволяет использовать --force-with-lease, собирая пакет только относительно trunk, и одновременно проверять, что ветка не ушла вперёд.
Самой системы в открытом доступе нет. OpenAI пишет, что рассматривает применение Pando для задач, где множество агентов работают над одним репозиторием, и «изучает способы поделиться технологией» с пользователями, но ни сроков, ни формата не называет.
Что из этого можно взять обычной команде
Для команд с обычным репозиторием на GitHub или GitLab практических последствий, по нашей оценке, немного: OpenAI описывает нагрузку в миллионы веток и десятки тысяч пакетов за день, с которой большинство команд не сталкивается. Полезны скорее сами идеи: объявлять клиенту меньше ссылок, переиспользовать пакеты вместо генерации уникальных, раздавать байты через кэш, а не через процессор сервера. Если вы держите собственный сервер Git, стоит следить за тем, что из правок OpenAI попадёт в ближайшие релизы Git — особенно за packfile-uri и параллельным индексированием.
Pando — уже не первый подобный рассказ за год. Cursor описывал свою систему хранения для больших репозиториев, а Anthropic рассказала о переработке системы контроля версий для своего монорепозитория. Подходы у компаний разные: Anthropic перенесла операции на сервер, Cursor разбирает ограничения хостинга Git, OpenAI сохранила протокол и переписала бэкенд. Общее, по нашей оценке, одно: инфраструктура, рассчитанная на темп людей, перестаёт справляться с темпом агентов. Об истории самого инструмента мы писали в материале к 20-летию Git, а о плюсах и минусах монорепозиториев — в отдельном разборе. Как OpenAI меняет лимиты самого Codex, читайте в новости об общей квоте ChatGPT и Codex.
Комментарии