
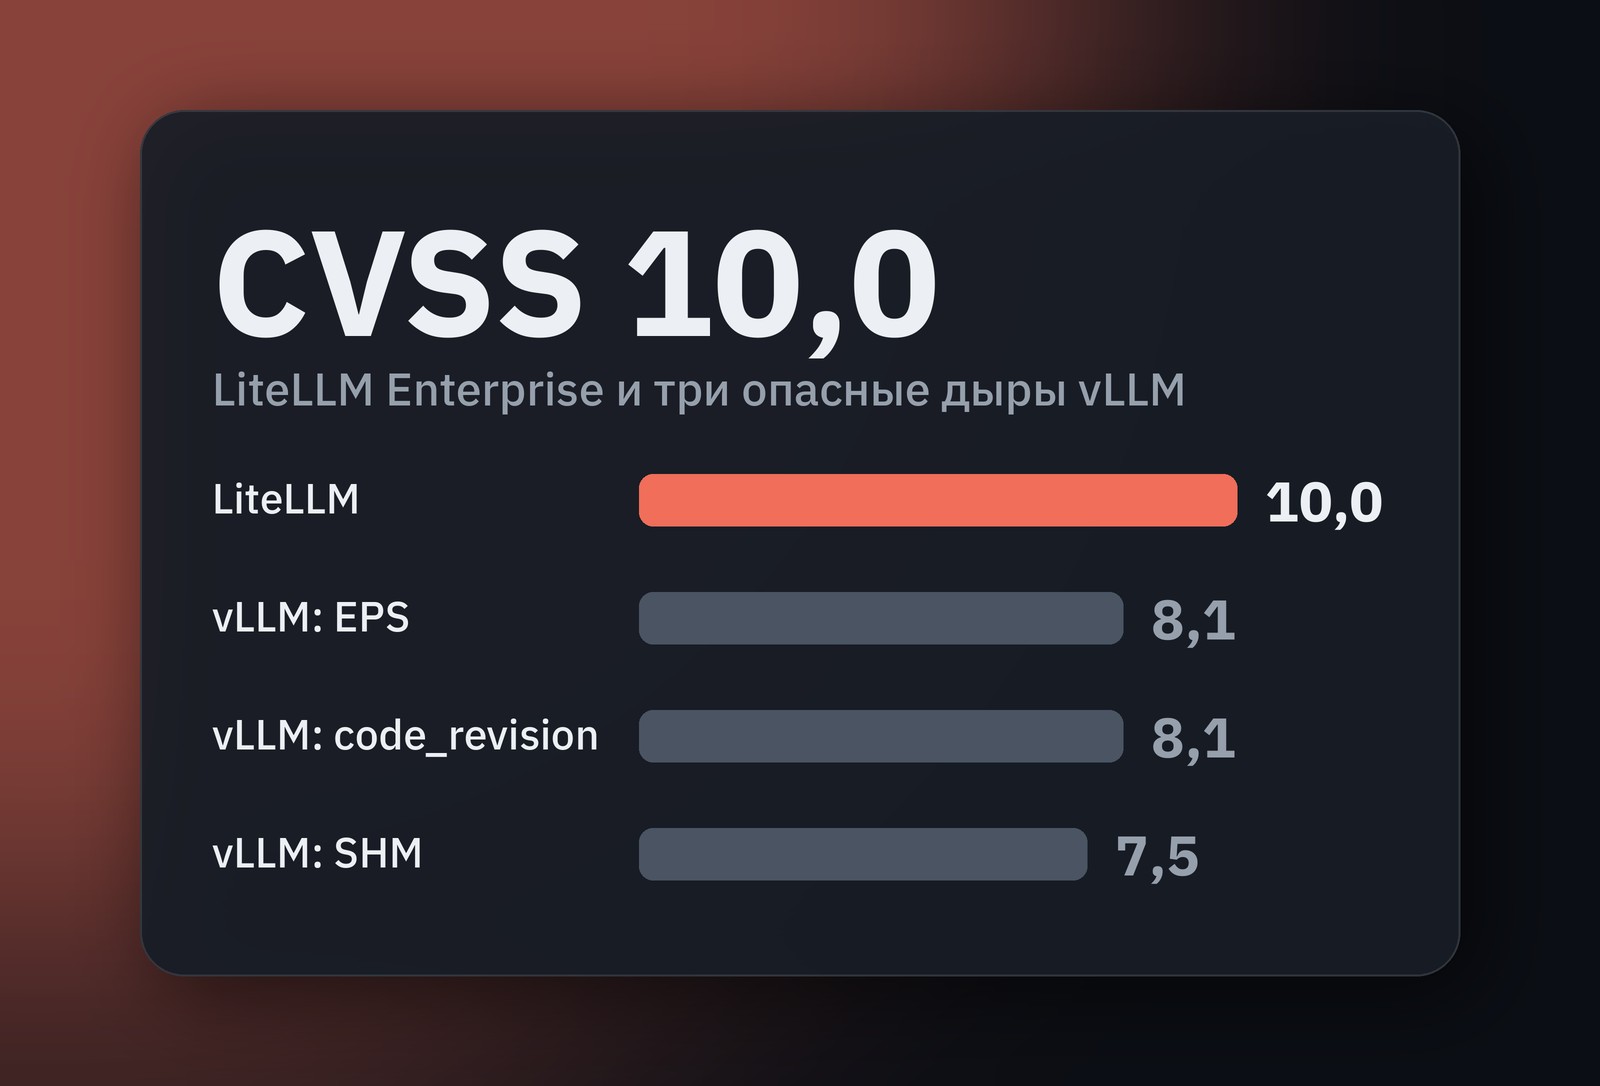
27–28 октября 2026 года в общую базу GitHub Advisory Database попали десять предупреждений об уязвимостях vLLM — одного из самых популярных движков для запуска языковых моделей на своих GPU. Три из них высокой опасности: при определённых настройках они позволяют выполнить код на сервере. В тот же день, 27 октября, BerriAI раскрыла критическую уязвимость в прокси LiteLLM с Enterprise-лицензией — 10 баллов из 10 по CVSS: запрос без ключа мог вытащить мастер-ключ прокси и ключи провайдеров. Исправления уже вышли: vLLM 0.31.0 и 0.32.0 (5 и 18 октября), LiteLLM 1.103.10, 1.104.8, 1.105.6 и 1.106.5.
Если у вас собственный инференс на vLLM или шлюз LiteLLM перед API OpenAI, Anthropic и других провайдеров, это повод проверить версии сегодня: оба компонента обычно видят GPU-сервер, ключи провайдеров и внутреннюю сеть. В отличие от взлома LiteLLM 1.107.0, о котором мы писали 26 октября, пакеты никто не подменял — это ошибки в коде самих проектов, и закрываются они обычным обновлением. Ниже — таблица всех предупреждений, механизм главных уязвимостей простыми словами, команды проверки и временные меры для тех, кто не может обновиться прямо сейчас.
- LiteLLM, CVSS 10,0: запрос без аутентификации к любому LLM-маршруту прокси с активной Enterprise-лицензией мог заставить прокси прочитать локальный файл и отправить его на адрес атакующего. Исправлено в 1.103.10, 1.104.8, 1.105.6 и 1.106.5, open source без лицензии не затронут.
- vLLM, три опасные уязвимости (8,1, 8,1 и 7,5): выполнение кода через EPS-картинку и Ghostscript, через подмену
code_revisionпри--trust-remote-codeи черезpickle.loads()в кэше--mm-processor-cache-type shm. - Ещё семь предупреждений vLLM — падение движка одним запросом, исчерпание памяти и потоков, обход запрета пользовательских шаблонов в Responses API и CORS «*» по умолчанию.
- Целевая версия vLLM — 0.32.0: она закрывает все десять. Но в ней же убрана поддержка Python 3.10 и закрыт CORS по умолчанию, поэтому браузерные клиенты нужно прописать явно.
- Об атаках не сообщалось: по данным HOL Guard, сведений об эксплуатации уязвимости LiteLLM нет, в каталоге CISA KEV её нет.
Какие версии затронуты и до чего обновляться?
Сводка ниже собрана по базе GitHub Advisory Database. Номера CVE получили все десять предупреждений vLLM, у LiteLLM номера CVE пока нет. Обратите внимание на даты: исправления vLLM вышли раньше раскрытия. Версия 0.31.0 вышла 5 октября, 0.32.0 — 18 октября. В репозитории vLLM разбор уязвимости с code_revision опубликовали 6 октября, остальные девять — 20 октября, а в общую базу GitHub Advisory Database, на которую смотрят сканеры зависимостей, их добавили 27–28 октября. Если вы обновились до 0.32.0 в середине месяца, вы уже защищены.
| ID, CVSS 3.1 | Суть и условия эксплуатации | Затронуты | Исправлено |
| GHSA-w4c7-34wj-hqm8 (LiteLLM), 10,0 | чтение локального файла и отправка на чужой адрес, утечка мастер-ключа. Условия: активная Enterprise-лицензия; ключ API не нужен | до 1.103.10; 1.104.x до 1.104.8; 1.105.x до 1.105.6; 1.106.x до 1.106.5 | 1.103.10, 1.104.8, 1.105.6, 1.106.5 |
| GHSA-h3rc-j82p-2c3h, 8,1 | EPS под видом PNG доходит до Ghostscript. Условия: мультимодальная модель, Ghostscript с CVE-2024-29510 на хосте | до 0.32.0 | 0.32.0 |
| GHSA-h3rc-6mm3-gc2m, 8,1 | запрос подменяет ревизию кода процессора модели. Условия: --trust-remote-code, процессор с auto_map, атакующий контролирует ревизию репозитория |
0.7.3 – 0.30.x | 0.31.0 |
| GHSA-6757-hggm-hp2w, 7,5 | подделка ссылки на разделяемую память, pickle.loads() в воркере. Условия: --mm-processor-cache-type shm, клиент с обычным ключом API |
до 0.32.0 | 0.32.0 |
| GHSA-q97c-p368-75c4, 6,5 | токен за пределами словаря роняет движок через CUDA assert. Условия: словарь кратен 64 (например, 32 000 у Llama 2), tensor parallel 1, токенизированный промпт | до 0.32.0 | 0.32.0 |
| GHSA-gq5q-89c7-vhvx, 6,5 | картинка с нулевой суммой пикселей роняет движок. Условия: модели семейства DeepSeek-OCR, настройки по умолчанию | 0.11.1 – 0.31.x | 0.32.0 |
| GHSA-8397-8qf6-f2gm, 6,5 | длинное аудио вызывает OOM энкодера. Условия: Phi-4 multimodal | до 0.32.0 | 0.32.0 |
| GHSA-542m-9234-8gvf, 6,5 | тяжёлый Jinja-шаблон намертво занимает поток рендеринга. Условия: клиент с ключом API или модель с вредоносным шаблоном | 0.19.0 – 0.31.x | 0.32.0 |
| GHSA-x567-49g5-p4cf, 6,5 | Responses API обходит trust_request_chat_template. Условия: эндпоинт /v1/responses, без явного --chat-template |
0.16.0 – 0.31.x | 0.32.0 |
| GHSA-frvg-qw88-hww9, 6,5 | исчерпание сокетов ZeroMQ в P2P-уровне кэша. Условия: OffloadingConnector с P2P-уровнем | до 0.32.0 | 0.32.0 |
| GHSA-vvpg-rrww-wpmh, 3,4 | CORS «*» по умолчанию, любая страница обращается к серверу через браузер. Условия: сервер без --api-key, доступный из браузера жертвы |
до 0.32.0 | 0.32.0 |
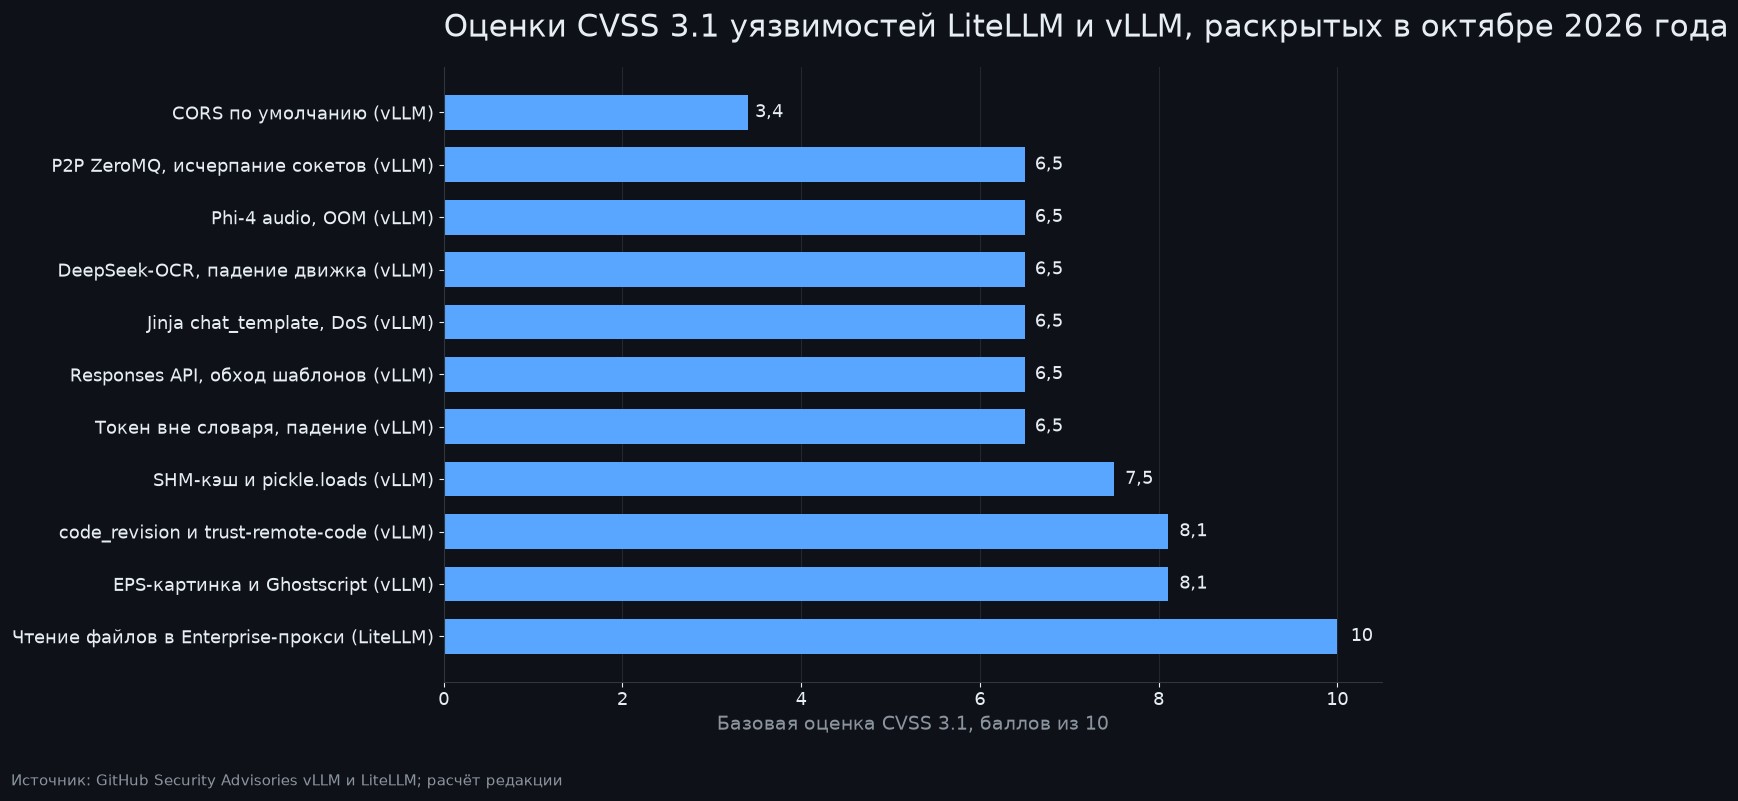
Оценки в сторонних базах могут отличаться. Например, для уязвимости с code_revision SecurityOnline публикует запись CVE-2026-114053 с оценкой 9,2 по CVSS 4.0, а сам vLLM ставит 8,1 по CVSS 3.1, отмечает автор рассылки The Daily Brief Раджеш Бери. Сканер вашей команды безопасности может показать её как критическую — это та же уязвимость, и её закрывает 0.31.0.
Как картинка превращается в выполнение команд в vLLM?
Через автоопределение формата в Pillow. Согласно предупреждению, загрузчик картинок vLLM передавал присланные байты в Image.open() без списка разрешённых форматов, а MIME-тип из запроса на выбор декодера не влиял. Файл с меткой image/png, который на деле был EPS, Pillow распознавал по сигнатуре и отдавал Ghostscript — внешней программе для PostScript. Если на хосте стоит Ghostscript с известной уязвимостью CVE-2024-29510 (обход песочницы -dSAFER, исправлен в 10.03.1), это выполнение команд с правами процесса vLLM.
Важная оговорка исследователя: выполнение команд воспроизведено на уровне загрузчика с PyPI-сборкой vLLM 0.30.0, Pillow 12.3.0 и Ghostscript 10.03.0 из Debian, а полный путь через HTTP прослежен по исходникам, но целиком не запускался. Сам vLLM Ghostscript не ставит. Тот же путь открывает и DoS через ошибку Pillow 12.0.0–12.2.0 (CVE-2026-59203), поэтому Pillow нужно обновить до 12.3.0 отдельно.
Требования vLLM не устанавливают Ghostscript. Ваш базовый образ — может.
Пример опасной конфигурации: CUDA-образ на полноценном дистрибутиве, в который кто-то доставил ghostscript ради обработки PDF, мультимодальная модель и эндпоинт чата, доступный внешним клиентам. В 0.32.0 недоверенные картинки открываются только из списка растровых форматов, EPS, PostScript и WMF запрещены.
Почему кэш в разделяемой памяти доходит до pickle.loads()?
Потому что воркер доверял ссылке, которую можно подделать. С флагом --mm-processor-cache-type shm vLLM кладёт обработанные мультимодальные данные в кольцевой буфер разделяемой памяти, а элемент кэша описывается парой «адрес и монотонный номер». По предупреждению, публичный маршрут scale-out (/inference/v1/generate) принимал от клиента готовое поле features.kwargs_data, и в нём можно было указать собственную пару, ведущую на байты, которые атакующий заранее положил в буфер обычным запросом к /v1/chat/completions. Воркер читал их и вызывал pickle.loads() — то есть исполнял произвольный Python.
Ключевая деталь: флаг VLLM_ALLOW_INSECURE_SERIALIZATION для этого не нужен, атака проходит при значении 0. Нужен лишь обычный ключ API, то есть угроза исходит от любого клиента многопользовательского эндпоинта. Уязвимость нашла программа Patch the Planet — совместный проект Trail of Bits и OpenAI, — по данным advisory, с помощью модели GPT-5.5-Cyber. В 0.32.0 ссылки на разделяемую память подписываются HMAC, поддельные отбрасываются.
        # Пример конфигурации, уязвимой до 0.32.0: общий эндпоинт с SHM-кэшем
vllm serve Qwen/Qwen2.5-VL-7B-Instruct \
  --api-key "$VLLM_API_KEY" \
  --mm-processor-cache-type shm
# Любой обладатель ключа API мог добраться до pickle.loads() в воркере
Когда --trust-remote-code становится удалённым выполнением кода?
Когда модель приносит свой Python-код процессора. Флаг --trust-remote-code разрешает Transformers импортировать код из репозитория модели — через auto_map в конфигурации процессора. Оператор обычно фиксирует и проверяет ревизию. Но, как описано в предупреждении, мультимодальный запрос мог передать в mm_processor_kwargs поле code_revision, и vLLM пробрасывал его в AutoProcessor.from_pretrained. Веса и конфигурация оставались закреплёнными, а код процессора загружался из другой ревизии того же репозитория — например, из чужого pull request на Hugging Face, если репозиторий их принимает.
Неприятный штрих: встроенная авторизация vLLM проверяет только префиксы /v1, /v2, /inference и /cohere. Эндпоинт /tokenize тоже принимает mm_processor_kwargs и остаётся открытым даже с --api-key, если его не закрывает внешний прокси — это прямо указано в руководстве по безопасности vLLM. Конфигурация по умолчанию (trust_remote_code=False) не затронута. С 0.31.0 параметры процессора из запроса отклоняются, пока сервер не запущен с --trust-request-mm-kwargs; клиенты, которые настраивали обработку картинок и видео в каждом запросе, начнут получать ошибки — такие настройки лучше перенести в конфигурацию сервера.
Как утечка одного файла в LiteLLM даёт полный доступ к прокси?
Через переменные окружения процесса. По advisory BerriAI, специально собранный запрос без аутентификации к любому LLM-маршруту прокси с Enterprise-лицензией мог заставить прокси прочитать локальный файл и отправить содержимое на адрес атакующего. Если прочитать /proc/self/environ, наружу уходят LITELLM_MASTER_KEY и ключи провайдеров, а мастер-ключ даёт полный доступ администратора. В некоторых конфигурациях это ведёт к выполнению Python-кода от root.
Подробную цепочку BerriAI не публиковала. Аналитики HOL Guard по исправлению #48599 реконструируют причину так: журнал отклонённых запросов собирался из сырого тела запроса, поэтому клиент без ключа мог задать параметры логирования для конкретного запроса — коллбэки Langfuse, LangSmith или GCS. Исправление строит такие журналы по списку разрешённых полей и привязывает логгер GCS к настроенным бакету и сервисному аккаунту. Сам атакующий шаг требует, чтобы прокси отправил украденный файл на внешний адрес, поэтому ограничение исходящего трафика ломает эксплуатацию.
Пример опасной конфигурации: контейнер LiteLLM с LITELLM_LICENSE, LITELLM_MASTER_KEY и OPENAI_API_KEY в переменных окружения, порт 4000 открыт в интернет, процесс работает от root, исходящий трафик не ограничен. Приложения, которые используют только Python SDK litellm без запуска прокси, advisory не касается.
Мы исходим из того, что атакующий трафик, который раньше шёл за advisory, теперь идёт за релизами.
Этим BerriAI объясняет, почему исправление сначала раздали закрыто: 6 октября компания подготовила патч и подняла временный приватный реестр пакетов для Enterprise-клиентов, а публичные версии и advisory вышли только 27 октября, через три недели. По словам компании, эмбарго затянулось на неделю дольше плана, потому что не все клиенты узнали об исправлении вовремя.
Что делать прямо сейчас?
Сначала проверьте версии в каждом образе, включая ноутбуки и вендорские сборки (у сторонних дистрибутивов номер версии upstream не гарантирует наличие патча):
        # vLLM: версии движка, Pillow и наличие Ghostscript в образе
pip show vllm pillow | grep -E '^(Name|Version)'
gs --version 2>/dev/null || echo "Ghostscript не установлен"

# Флаги запуска, при которых опасные уязвимости срабатывают
ps -eo args | grep '[v]llm serve' | tr ' ' '\n' \
  | grep -E -- '^--(trust-remote-code|mm-processor-cache-type|api-key)'

# LiteLLM: версия и наличие лицензии (значение не печатаем)
pip show litellm | grep '^Version'
printenv LITELLM_LICENSE >/dev/null && echo "Enterprise-лицензия задана"
Затем обновитесь. Для vLLM 0.32.0 нужен Python 3.11 или новее; в ней же CORS по умолчанию закрыт, браузерные клиенты прописываются через --allowed-origins.
        # vLLM
pip install -U "vllm==0.32.0" "pillow>=12.3.0"
# или образ
docker pull vllm/vllm-openai:v0.32.0

# Ghostscript в образе инференса обычно не нужен: удалите его
# если он всё же нужен, версия от 10.03.1
apt-get remove -y ghostscript

# LiteLLM: последняя версия вашей ветки
# или 1.105.6, 1.104.8, 1.103.10 в своей ветке
pip install -U "litellm[proxy]>=1.106.5,<1.107"
docker pull ghcr.io/berriai/litellm:v1.106.5
Если обновить LiteLLM сегодня нельзя, BerriAI предлагает три временные меры. Первая — на WAF, ingress или обратном прокси отбрасывать POST-запросы, в JSON-теле которых есть ключи callbacks, success_callback, failure_callback, standard_callback_dynamic_params или gcs_path_service_account. Вторая — разрешить прокси исходящие соединения только к адресам ваших LLM-провайдеров. Третья — убрать прокси из публичного интернета: VPN, mTLS, ingress с аутентификацией или allowlist IP. Учтите, что фильтр должен разбирать JSON-тело: например, в ModSecurity сырое тело JSON-запроса в REQUEST_BODY по умолчанию не попадает, поэтому нужен JSON-обработчик тела и проверка имён аргументов. Перед включением блокировки убедитесь, что ваши легитимные клиенты не передают эти поля.
Если Enterprise-прокси на уязвимой версии был доступен из интернета и исходящий трафик не ограничивался, по нашей оценке, разумно считать мастер-ключ и ключи провайдеров из окружения скомпрометированными. Ключи провайдеров перевыпускаются в их консолях. С мастер-ключом осторожнее: по документации LiteLLM, без отдельного LITELLM_SALT_KEY он же шифрует сохранённые в базе учётные данные, и простая замена переменной сделает их нечитаемыми. Порядок такой: сделать резервную копию базы; если LITELLM_SALT_KEY задан, сменить LITELLM_MASTER_KEY во всех местах и перезапустить все экземпляры прокси, сам salt не трогать; если не задан — вызвать POST /key/regenerate с текущим мастер-ключом и новым в поле new_master_key (прокси перешифрует модели и учётные данные), затем обновить ключ в окружении, менеджере секретов и general_settings.master_key и перезапустить все экземпляры. Виртуальные ключи хранятся в виде хешей и продолжат работать. BerriAI также советует хранить мастер-ключ в менеджере секретов, а не в окружении процесса. Для vLLM закройте /tokenize и другие неавторизуемые эндпоинты на внешнем прокси и не отдавайте --trust-remote-code и SHM-кэш на эндпоинты, где клиентам не доверяют.
Чем это отличается от взлома LiteLLM 1.107.0?
Механизмом и тем, что нужно делать. 21 октября атакующие с помощью утёкшего ключа добрались до конвейера выпуска LiteLLM и опубликовали версию 1.107.0 со стилером — разбирали эту атаку на цепочку поставки подробно. Там лечение — пересборка окружения и ротация всех секретов хоста, а версия 1.107.0 изъята с PyPI. Сейчас пакеты подлинные, а дефект сидит в коде прокси, поэтому надо обновиться в своей ветке, а если уязвимый прокси был доступен атакующим, ещё и сменить ключи, которые могли утечь. Аналитики HOL Guard формулируют это прямо:
Это не компрометация цепочки поставки, как с 1.107.0: опубликованные пакеты не подменялись.
| Дата, 2026 | Событие |
| 5 октября | vLLM 0.31.0: закрыта подмена code_revision |
| 6 октября | vLLM публикует в репозитории advisory о code_revision |
| 6 октября | BerriAI готовит исправление и раздаёт его Enterprise-клиентам через приватный реестр |
| 18 октября | vLLM 0.32.0: закрыты EPS/Ghostscript, SHM/pickle и ещё семь проблем |
| 20 октября | vLLM публикует в репозитории девять advisory к 0.32.0 |
| 21 октября | отдельный инцидент: заражённая LiteLLM 1.107.0 на PyPI и в Docker |
| 27 октября | LiteLLM 1.103.10, 1.104.8, 1.105.6, 1.106.5 на PyPI, публикация GHSA-w4c7-34wj-hqm8 |
| 27–28 октября | десять advisory vLLM добавлены в общую GitHub Advisory Database |
Окно между патчем и атакой сокращается: в октябре PHP-серверы атаковали ещё до выхода исправлений. LiteLLM пообещала в ближайшие недели описать постоянный приватный реестр для критических исправлений и думает, как подключить к нему open source-пользователей. Тем, кто разворачивает vLLM по старым гайдам, вроде связки vLLM и TorchServe, стоит пересмотреть флаги запуска: в 0.32.0 изменились CORS, минимальная версия Python и резервирование max_tokens из окна контекста, поэтому обновление лучше прогнать на стенде с реальными клиентами.
Источники
- https://github.com/BerriAI/litellm/security/advisories/GHSA-w4c7-34wj-hqm8
- https://github.com/vllm-project/vllm/security/advisories
- https://github.com/advisories/GHSA-h3rc-j82p-2c3h
- https://github.com/advisories/GHSA-6757-hggm-hp2w
- https://github.com/advisories/GHSA-h3rc-6mm3-gc2m
- https://github.com/vllm-project/vllm/releases/tag/v0.32.0
- https://github.com/vllm-project/vllm/releases/tag/v0.31.0
- https://docs.litellm.ai/blog/litellm-private-registry
- https://github.com/BerriAI/litellm/pull/48599
Комментарии