
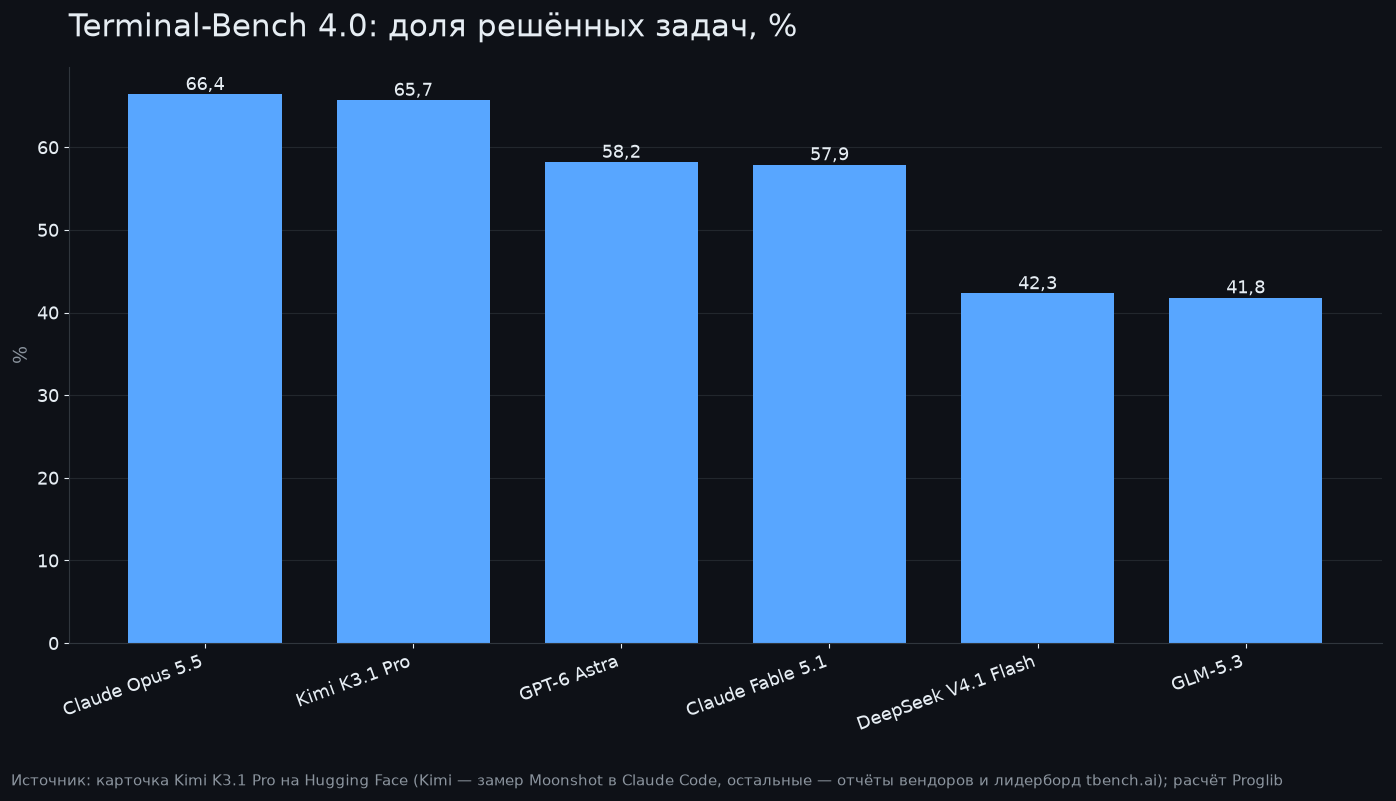
Moonshot AI 4 ноября 2026 года опубликовала веса Kimi K3.1 Pro в открытом репозитории на Hugging Face. Компания обещала это при запуске модели 23 октября и уложилась в названный срок. Речь о той самой модели, которая по замерам Moonshot отстала от Claude Opus 5.5 на 0,7 процентного пункта в Terminal-Bench 4.0.
Разбираемся, во что обходится самостоятельный запуск: сколько весят файлы, на каком железе работают официальные рецепты vLLM и SGLang, что именно разрешает лицензия и что говорят первые независимые замеры.
Репозиторий весит 1,56 ТБ, и это уже сжатая версия
Kimi K3.1 Pro — модель со смесью экспертов (MoE): 2,8 трлн параметров, из которых на каждом токене работают 104 млрд. По карточке модели, в ней 93 слоя, 896 экспертов, по 16 выбираемых и 2 общих на токен, контекст 1 048 576 токенов и энкодер изображений MoonViT-V2 на 401 млн параметров. Это дообученная версия Kimi K3 с большим объёмом обучения с подкреплением, а не новая базовая модель.
Веса опубликованы в формате MXFP4: 4-битные числа с плавающей точкой и общий 8-битный масштаб на каждую группу из 32 значений. Так сжаты веса маршрутизируемых экспертов; слои внимания, общие эксперты, маршрутизатор, выходная проекция и энкодер изображений из этой схемы исключены (список в config.json), а остальные веса рецепт vLLM описывает как BF16. Модель обучали с учётом квантования, и отдельного чекпоинта в BF16 в репозитории нет.
По данным API Hugging Face, в репозитории 112 файлов, из них 96 safetensors общим объёмом 1 561 293 160 568 байт — 1,56 ТБ, в среднем около 4,5 бита на параметр. Столько же занимает Kimi K3 в том же формате. Для сравнения, Mistral Large 4 в FP8 занимает 1,06 ТБ, DeepSeek V4 Pro — 865 ГБ, GLM-5.3 — 756 ГБ, DeepSeek V4.1 Flash — 510 ГБ.
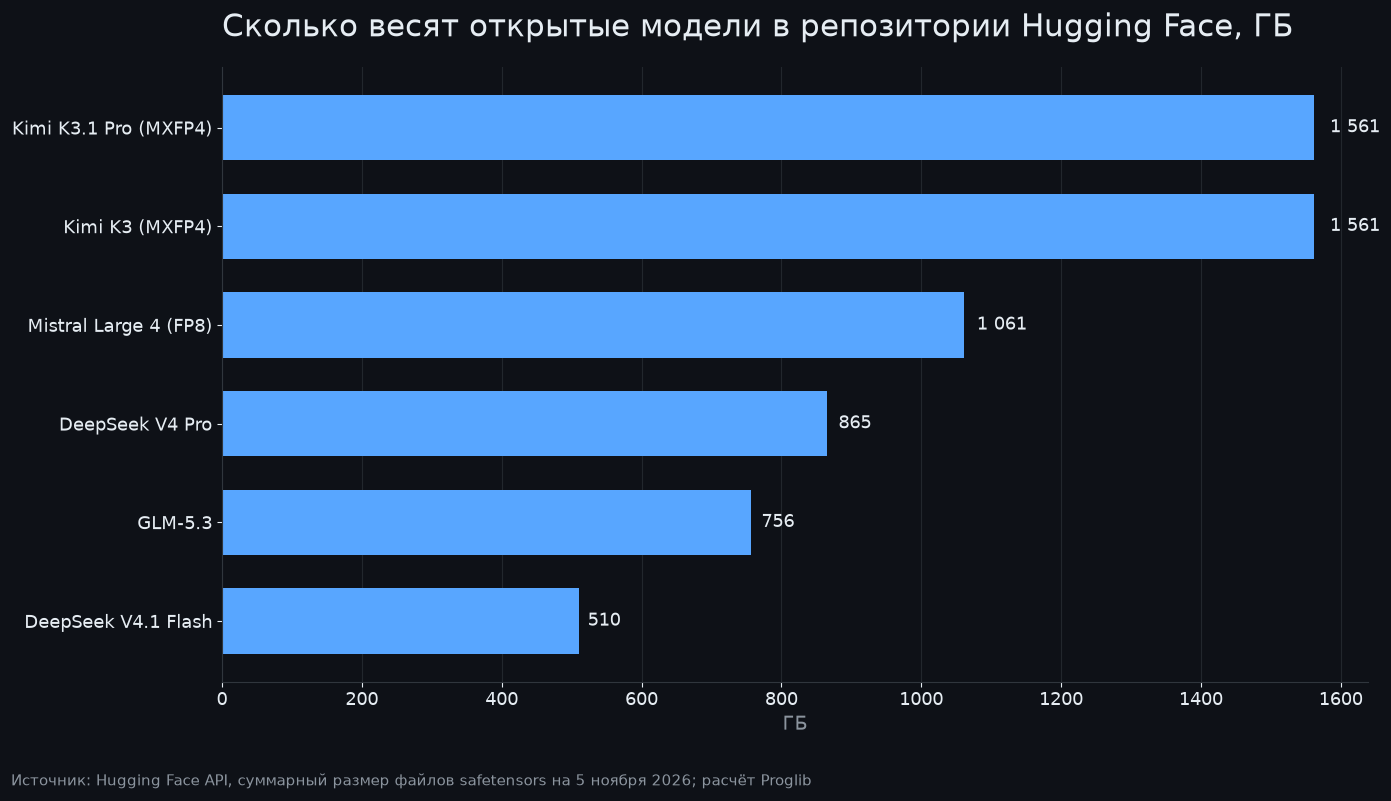
Загрузка такого объёма даже при стабильном гигабитном канале занимает не меньше трёх с половиной часов, и это только диск. В видеопамяти, помимо весов, нужно место под кеш контекста, поэтому официальные рецепты рассчитаны на серверный узел с восемью GPU или несколько узлов.
Официальные рецепты рассчитаны на восемь B300 или MI355X
Moonshot рекомендует три движка: vLLM, SGLang и TokenSpeed. В рецепте vLLM базовой названа одна группа тензорного параллелизма на 8 GPU: две полки GB300 NVL4, один узел с восемью NVIDIA B300 или один узел с восемью AMD MI355X. Нужен vLLM 0.34.0 или новее, для AMD и Vera Rubin подготовлены отдельные образы. Команда запуска для двух узлов GB300 выглядит так:
        export GLOO_SOCKET_IFNAME=$IFACE_NAME
export NCCL_SOCKET_IFNAME=$IFACE_NAME
export VLLM_ENGINE_READY_TIMEOUT_S=3600

vllm serve moonshotai/Kimi-K3.1-Pro \
  --trust-remote-code \
  --tensor-parallel-size 8 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr $HEAD_IP \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Авторы рецепта приводят и первые замеры на восьми B300 по одному запросу за раз: предзаполнение (prefill) запроса на 340 тысяч токенов до первого токена ответа занимает около 10 секунд в режиме тензорного плюс экспертного параллелизма против 15 секунд при обычном TP8. Режим DCP8, в котором кеш контекста делится между восемью GPU, вмещает в кеш около 18,5 млн токенов суммарно по всем запросам при FP8-кеше против 2,6 млн при TP8, окно одного запроса остаётся 1 048 576 токенов, а декодирование при той же партии замедляется на 7–25%. Это цифры из документации vLLM на предрелизной версии весов, а не независимый тест.
Кулинарная книга SGLang шире по списку железа. SGLang собирается из ветки kimi-k3.1-day-0 (зависимости — по docker/k31.Dockerfile) или берётся готовым образом:
        git clone -b kimi-k3.1-day-0 https://github.com/sgl-project/sglang.git && cd sglang
pip install -e "python"

# или готовый образ
# docker: lmsysorg/sglang:dev-kimi-k31-pro
# для AMD MI350X / MI355X: lmsysorg/sglang:dev-kimi-k31-pro-mi35x
Раскладка по платформам в SGLang такая: TP8 на B300 и GB300, TP16 с DCP16 на B200 и GB200, TP16 с экспертным параллелизмом на 16 H200, TP32 на 32 H100 и TP32 с EP8 на 16 чипах TPU7x. Проверенными на 5 ноября помечены только отдельные конфигурации на B300 и на AMD MI350X и MI355X, остальные — шаблоны, которые ждут верификации. Авторы предупреждают, что число одновременных запросов упирается в пул состояний линейного внимания KDA в FP32 — около 52 МБ на запрос на каждый GPU при TP8, — а кеш внимания и индексера занимает около 18,9 КБ на токен и шардируется между GPU только в режиме DCP.
Для тех, у кого такого железа нет, остаётся API. Официальная цена — $2 за миллион входных токенов, $10 за миллион выходных и $0,20 за миллион токенов из кеша; API совместим с форматами OpenAI и Anthropic, а глубина рассуждения задаётся полем reasoning_effort со значениями low, high и max. Сторонние провайдеры подняли модель в первые часы: на OpenRouter её отдают несколько хостеров. Разворачивая движок у себя, обновляйтесь до актуальной версии: рецепт для K3.1 требует vLLM не ниже 0.34.0, а о недавних уязвимостях vLLM мы писали отдельно.
Лицензия разрешает почти всё, кроме крупного хостинга без договора
Собственная лицензия Kimi K3.1-Pro построена на тексте MIT: разрешено использовать, изменять, распространять, продавать копии, дообучать и создавать производные работы при сохранении уведомления об авторских правах и текста разрешения и при соблюдении законов. К этому добавлены три условия.
- «Модель как сервис» — предоставление третьим лицам доступа к инференсу или дообучению, например по API, с существенным контролем над входами, параметрами или данными. Если компания и её аффилированные лица ведут такой бизнес и их совокупная выручка превышает $20 млн за любые 12 месяцев подряд, перед любым коммерческим использованием модели и производных нужен отдельный договор с Moonshot. Продукты, где возможности модели встроены только в конкретные функции, и переадресация запросов к чужому хостингу под определение не попадают.
- Коммерческий продукт или сервис с более чем 100 млн активных пользователей в месяц или более $20 млн месячной выручки обязан заметно показывать название «Kimi K3.1-Pro» в интерфейсе.
- Оба условия не действуют при внутреннем использовании, когда модель и её результаты не предоставляются третьим лицам, а также при доступе через официальные продукты Moonshot и сертифицированных партнёров.
Порог похож на тот, что Mistral ввела для Large 4. Лицензия не уточняет методику подсчёта выручки группы компаний и не касается экспортного контроля; как на публикацию весов повлияет проект китайского каталога ограниченных к экспорту технологий, станет ясно после окончания его обсуждения 15 ноября.
Независимые замеры осторожнее, чем таблица Moonshot
Сводная таблица в карточке модели опубликована самой компанией и смешивает собственные замеры с заимствованными: в Terminal-Bench и SWE Marathon Kimi гоняли в оболочке Claude Code с максимальным рассуждением, в других тестах методики различаются, цифры конкурентов в основном взяты из их отчётов и лидербордов. По ней K3.1 Pro набирает 65,7% в Terminal-Bench 4.0 против 66,4% у Claude Opus 5.5, 51,7% в SWE Marathon против 46,3%, 70,0% в HLE-Full с инструментами против 67,7%. В той же таблице есть и отставания: 31,5 против 65,0 в Program Bench (доля задач с результатом не ниже 95%), 39,4% против 60,9% в HLE-Diamond, 74,7 против 91,0 балла в ExploitBench по метрике максимальных возможностей pass@5.
Кибервозможности Moonshot ограничивала намеренно: для открытого выпуска материалы по кибербезопасности убрали из данных промежуточного обучения и из RL-сред, и на внутреннем xdev-bench-hard итоговая модель решает 81,0% задач при pass@3 против 90,5% у чекпоинта без этих мер. В блоге компании это названо принципом: открытые веса не должны расширять передний край наступательных кибервозможностей.
Artificial Analysis после выхода модели 23 октября поставила её на четвёртое место тогдашней версии Intelligence Index с 55 баллами, но 27 октября индекс обновили до версии 5 с новыми закрытыми тестами. На странице модели на 5 ноября указано 46 баллов и 22-е место из 69; среди моделей впереди — Gemini 4 Carbon с 60 баллами, Claude Opus 5.5 с 59 и GPT-6 Astra с 57. Там же отмечено, что через API Kimi модель медленная: 36 минут на задачу индекса против медианных 12,5 у моделей сопоставимой цены и 33 токена в секунду при $3,68 за задачу.
В обсуждении на Hacker News — 600 очков и 172 комментария на 5 ноября — часть разработчиков считает модель заточенной под бенчмарки. Дэниел Маккиннон, исследователь на стыке ИИ и генетики из Gamow Labs, ответил результатами своего теста RareBench, проведённого через API до выхода весов:
Заточена ли K3.1 под бенчмарки? Не думаю. Они набирают весьма сильные 38% на RareBench, ровно столько же, сколько GPT-6 Astra, и на 10 процентных пунктов больше, чем K3. RareBench — сложная, отложенная для оценки, долгая агентная задача, под которую, на мой взгляд, практически невозможно подстроиться. <…> И всё это примерно за $250, то есть примерно за четверть цены закрытых флагманов.
Независимых прогонов именно опубликованного чекпоинта в проверенных нами источниках нет: Artificial Analysis измеряла Kimi через API, тест Маккиннона прошёл до выхода весов. Следующее, за чем стоит следить, — появление K3.1 Pro в лидербордах с пометкой «открытые веса», первые квантованные сборки сообщества (GGUF для llama.cpp в официальном репозитории на 5 ноября нет) и проверка того, насколько разреженное внимание на 24 слоях действительно экономит память на длинных контекстах. Для большинства команд практический вывод прежний: попробовать через API на своих задачах, а решение о собственном кластере принимать по результатам, а не по таблице вендора.
Источники
- https://huggingface.co/moonshotai/Kimi-K3.1-Pro
- https://huggingface.co/moonshotai/Kimi-K3.1-Pro/blob/main/LICENSE
- https://x.com/Kimi_Moonshot/status/2118010528123773297
- https://www.kimi.ai/blog/kimi-k3-1-pro
- https://recipes.vllm.ai/moonshotai/Kimi-K3.1-Pro
- https://docs.sglang.io/cookbook/autoregressive/Moonshotai/Kimi-K3.1-Pro
- https://artificialanalysis.ai/models/kimi-k3-1-pro
- https://news.ycombinator.com/item?id=50366999
- https://proglib.io/p/kimi-k3-1-pro-dogonyaet-claude-opus-5-5-a-pekin-gotovit-eksportnyy-kontrol-ii-2026-10-26
- https://proglib.io/p/mistral-otkryla-vesa-large-4-model-dlya-koda-mozhno-zapuskat-na-svoih-serverah-2026-10-30
Комментарии