
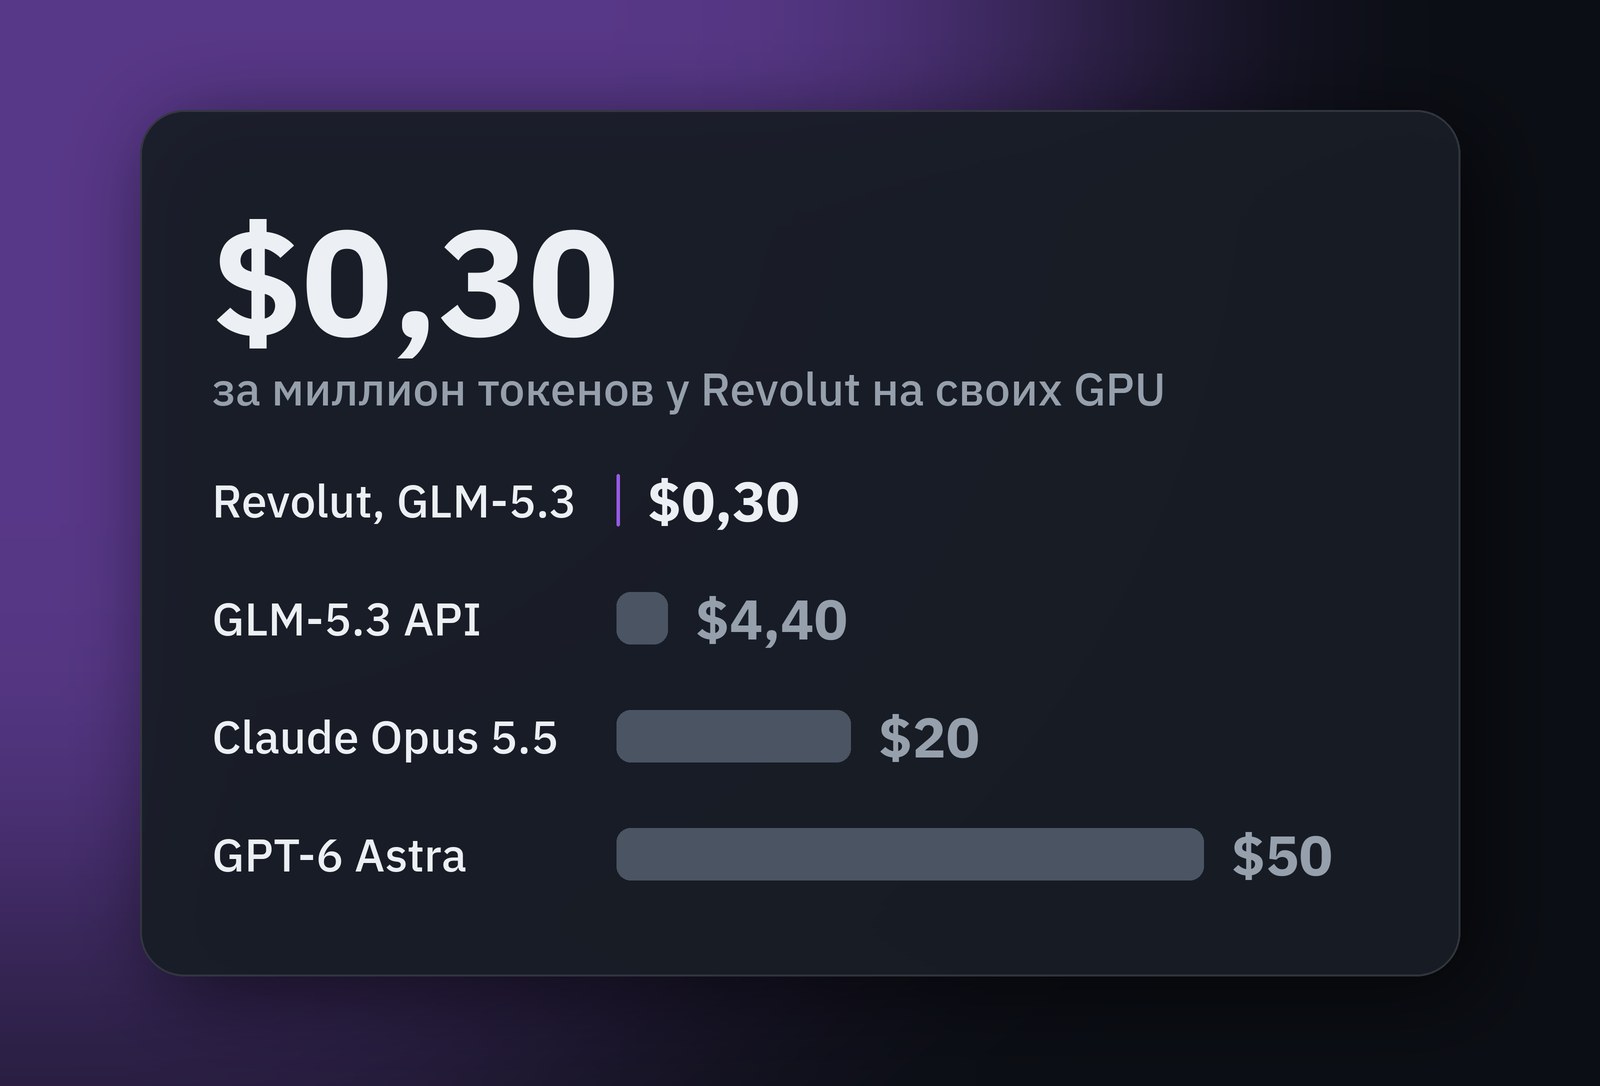
Revolut, крупнейшая частная компания Европы с 80 млн клиентов на 45 рынках, перевела около 2000 инженеров на открытую модель GLM, которая работает на выделенных GPU банка, а Claude Code и Codex оставила как исключение. Детали раскрыл в докладе на конференции AI Engineer в Нью-Йорке (выступление 13 октября, запись вышла 29 октября 2026 года) Давид Абитбол, отвечающий в Revolut за эксплуатацию ИИ: 56 NVIDIA B200 на всех, смешанная цена $0,30 за миллион токенов и счёт в 10 раз меньше, чем компания платила Anthropic и OpenAI. 3 ноября 2026 года The Register пересказал отчёт Gartner с прогнозом: к 2030 году 90% операционных шагов корпоративных агентов будут выполняться на моделях с открытыми весами.
Разбираемся, из каких ограничений Revolut собрала свою экономику (контекст 256 тыс., FP4, песочница с правилами команд), что в $0,30 не входит и почему Gartner называет модели товаром, а ценность отдаёт харнессам.
- Цифры Revolut: 56 B200 на 2000 инженеров, смешанная цена $0,30 за миллион токенов (что усреднено, не уточнено), счёт в 10 раз меньше; по внутренним замерам банка, lead time от взятия задачи до merge сократился на 70%, время написания кода на 60% (данные доклада Давида Абитбола, независимого подтверждения нет).
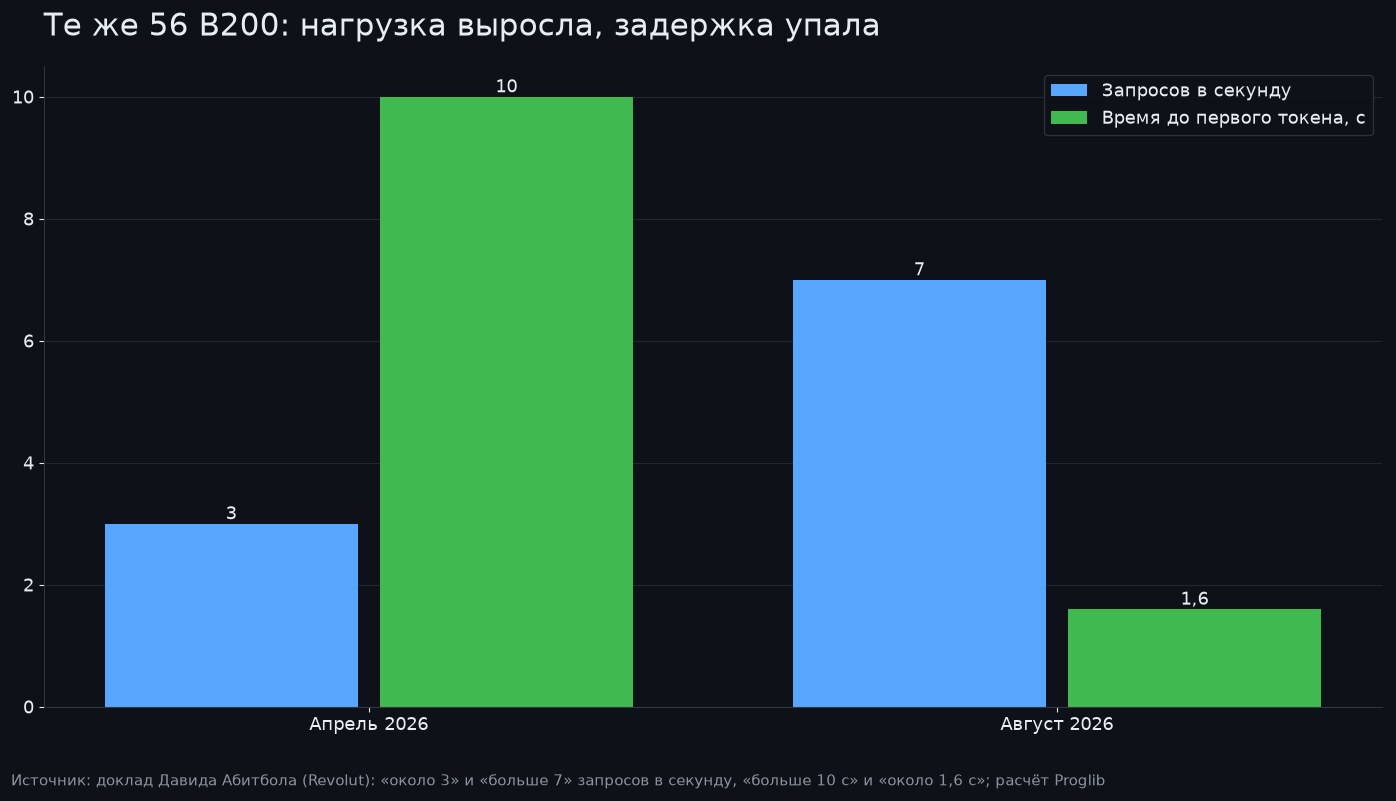
- Тюнинг вместо закупки: на тех же 56 GPU с апреля по август 2026 года время до первого токена, по слайду доклада, снизилось на 88% (с 14,26 с до 1,68 с) при росте нагрузки на 76%; крайние точки графика — около 3 и больше 7 запросов в секунду.
- Gartner: 9 из 10 шагов агентных процессов рутинные; открытая модель при равном балле стоит четверть от самой дешёвой закрытой, против фронтирной на каждом шаге до двадцатой части, но с учётом многословия и повторов реальная экономия 5–6 раз на задачу (оценка аналитиков Марка Петти и Раймонда Паке).
- Чего в цифрах нет: стоимость самих GPU, команды эксплуатации и мониторинга, а также доля задач, которые всё равно уходят в Claude Code и Codex; по сторонним оценкам, одни только 56 чипов B200 стоят $1,7–2,2 млн, семь готовых серверов на них около $2,7 млн, а аренда $245–327 тыс. в месяц.
Год замеров: Gemini дала 10%, Claude Code с лимитами почти ничего, своя GLM 70%
Главный аргумент доклада не цена, а два графика по выборке из 2000 инженеров за год: lead time в днях от момента, когда инженер берёт задачу, до merge, готового к деплою, и время написания кода в часах. Первым ИИ в компании в январе 2025 года стала Gemini: lead time сократился на 10%, кодирование на 20%, потому что инженеры перестали ходить в Stack Overflow и документацию. Claude Code начали пробовать в феврале 2025 года, в масштабе запустили позже и со строгими бюджетами: отдельные инженеры тратили, по словам Абитбола, $1000–10 000 в месяц без заметной отдачи, и на графиках этот этап почти не виден.
В апреле 2026 года Revolut подняла у себя GLM-5.1, и время кодирования сократилось на 60%, lead time на 70%. Абитбол подчёркивает асимметрию: написание кода не обязательно является узким местом, а когда токены не нужно беречь до конца квартала, инженеры отдают ИИ и разбор почты, и Jira, и Confluence. Это замер одной компании без контрольной группы: эффект модели, отмены лимитов и параллельных изменений процессов в нём не разделён. Сейчас инженеров обслуживает GLM-5.3, модель примерно на 800 млрд параметров; на слайде доклада кластер подписан как «56 x B200 with Together», то есть, судя по слайду, это выделенные GPU у Together AI, хотя куплены они или арендованы, Абитбол не сказал.
$0,30 за миллион: что это значит и с чем сравнивать
Что именно усреднено в «смешанной» цене, вход, выход или их доля, Абитбол не уточнил; в публичных API вход и выход стоят по-разному, поэтому сравнение условно, но порядок величин показывает. GLM-5.3 в API Z.ai стоит $1,40 за миллион входных и $4,40 за миллион выходных токенов, GLM-5.3-Flash $0,15 и $0,50, Claude Opus 5.5 $4 и $20, Claude Sonnet 5.5 и GPT-6.1 Sol по $2 и $10, Claude Fable 5.1 и GPT-6 Astra по $10 и $50 (прайс Z.ai, прайс Anthropic, прайс OpenAI, проверены 5 ноября 2026 года).
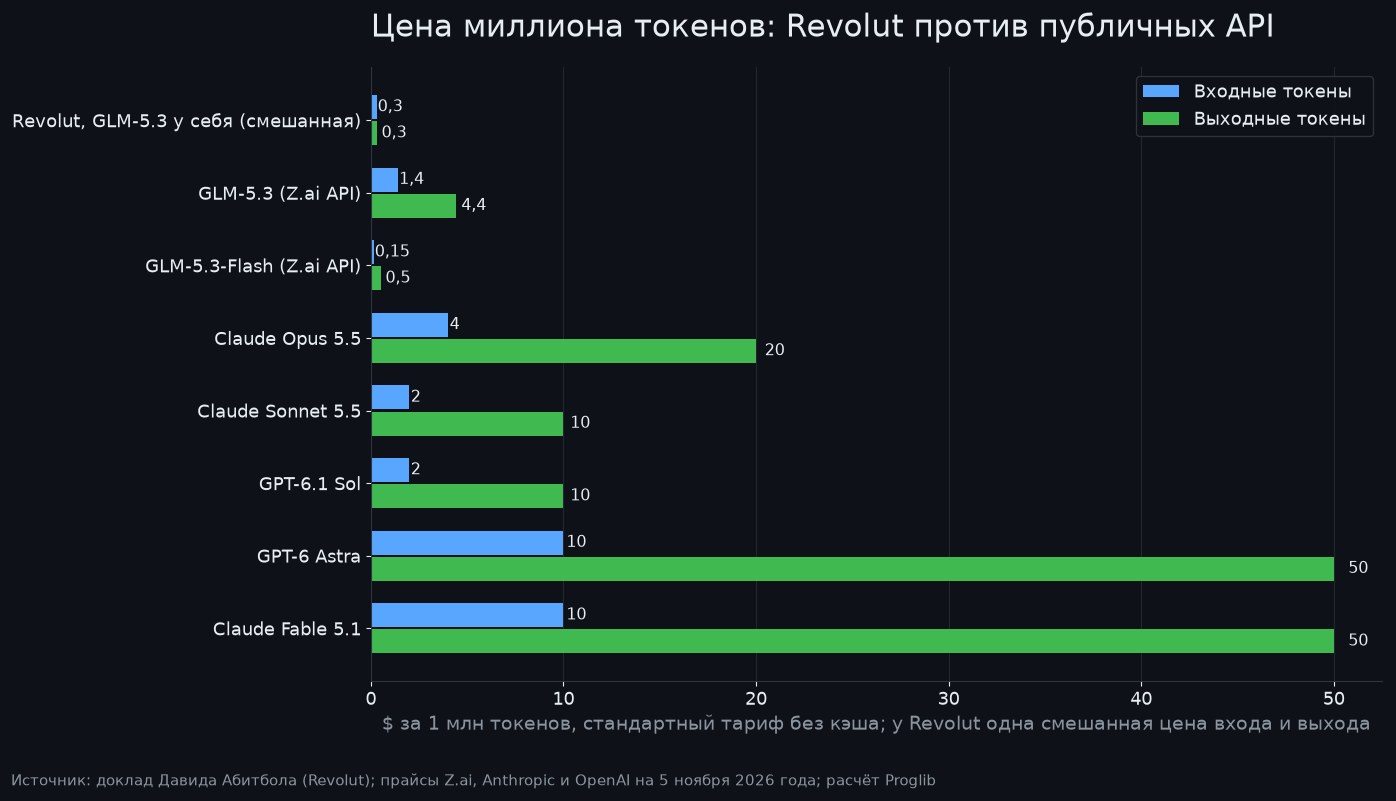
Чего в $0,30 нет, в докладе не сказано. Trending Topics со ссылкой на разбор StartupHub.ai отмечает, что экономия 90% не учитывает облако, персонал и мониторинг, и напоминает цену железа: при анонсе B200 Дженсен Хуанг называл $30–40 тыс. за чип, то есть $1,7–2,2 млн за 56 штук. BigGo Finance считает от сервера на восемь B200 за $390 700 (около $2,7 млн за кластер) и от аренды по $6–8 за GPU-час (от $245 до $327 тыс. в месяц, примерно $120–165 на инженера). Обе оценки сторонние, Revolut расходы на железо не раскрывала.
Ограничения как рычаг: 256 тыс. контекста, FP4 и кэш выше 90%
Самая инженерная часть доклада про то, что из коробки инференс был, по словам Абитбола, «ужасным», и всё дальнейшее улучшение пришло от настройки, а не от новых карт. С апреля по август 2026 года кластер оставался на 56 B200, при этом число запросов в секунду выросло примерно с 3 до 7 с лишним, а время до первого токена упало с 10 с до 1,6 с (крайние точки графика). На слайде итог сформулирован как снижение задержки до первого токена на 88%, с 14,26 с в разгар миграции до 1,68 с в стабильном режиме, при росте нагрузки на 76% между теми же периодами. Целевые метрики у банка эмпирические: меньше 3 с до первого токена, потому что после 5 с «взрывается Slack», и около 200 токенов в секунду на пользователя, поскольку инженеры больше не читают поток рассуждений, а запускают задачи параллельно; вечером на пустом кластере можно получить и 800 токенов в секунду.
| Параметр | Что выбрала Revolut | Почему, по словам Абитбола |
| Контекст | 256 тыс. токенов вместо 1 млн | «Длинный контекст — это скам»: кодингу хватает 256 тыс., а память нужнее под KV-кэш |
| Квантизация | FP4, лучше NVFP4, на Blackwell | Более низкая точность заметно экономит GPU без потери качества (утверждение докладчика, замеров нет) |
| Тензорный параллелизм | TP4 помещается, но TP8 может работать лучше | В TP4 модель помещается, но не хватает KV-кэша; выбор зависит от нагрузки, свою конфигурацию Revolut не назвала |
| Кэш | Попадание выше 90% | Ниже этого порога у задач кодинга портятся и экономика, и задержка |
| Зрение | Роутер в Gemini, Flash-версия GLM для UI | GLM текстовая; умнее взять сильную текстовую модель и решить картинки отдельно |
Эндпоинты OpenAI-совместимы и поддерживают Responses API, поэтому инженеры работают из OpenCode, Codex CLI и приложения Codex, а подключить можно любой агентный клиент, который поддерживает этот протокол и позволяет указать свой провайдер, модель и аутентификацию. Это та самая логика «харнесс важнее модели», о которой пишет Gartner: оболочка решает, куда уйдёт шаг, и чем она умнее, тем меньше задач доходит до дорогих API.
Как банк объясняет регулятору китайскую модель
Revolut работает под самым строгим режимом комплаенса ЕС, и Абитбол отдельно обратился к CIO в зале. Стигма вокруг китайских открытых моделей, по его словам, не про веса: банк не ходит в инференс-эндпоинт в Китае, а берёт опубликованные веса и запускает на сервисе в США. По его словам, данные остаются в юрисдикциях с эквивалентной защитой (он назвал США, ЕС, Великобританию и Израиль; для США решение Еврокомиссии об адекватности распространяется только на компании-участницы EU-US Data Privacy Framework), а провайдеры инференса работают с нулевым хранением данных. Для надзора кодовые задачи оформлены как работа с человеком в контуре, а не как автономные агенты: песочница с явными правилами команд (разрешить grep, но не Gradle), защита от злоупотреблений изнутри компании и от prompt injection, полная телеметрия через OpenTelemetry, чтобы при инциденте поднять логи.
Gartner: модели стали товаром, ценность ушла в харнесс
Отчёт «Open-Weight Models Will Run 90% of Enterprise Agentic Workflow Steps» написали старший директор Gartner Марк Петти и вице-президент Раймонд Паке; документ платный, его цитирует The Register. Типичный операционный процесс, по их описанию, состоит из сотен рутинных исполнений (классификация, вызов инструментов, разбор, проверка и сверка данных), и открытые модели «справляются с сотнями таких шагов на каждый, где нужно фронтирное рассуждение». При равном балле открытая модель стоит четверть от самой дешёвой закрытой, а против фронтирной на каждом шаге «всего двадцатую часть». Это лучший случай, и аналитики оговаривают его сами.
Нынешние открытые модели могут быть многословнее и чаще повторять попытки, так что экономия на задаче против фронтирной модели ближе к пяти-шести разам.
Экономию Gartner называет бонусом. Главный довод про контроль: годы истории рабочих процессов это большая часть того, за что платят при покупке SaaS-компании, и каждый рутинный шаг, отправленный во фронтирный API, выносит кусок этой истории за периметр. Отсюда прогноз на 2030 год и вывод, что ценность в харнессах: оболочках, которые запускают агентов, маршрутизируют шаги по моделям, держат ограничения и управляют парком агентов. Фронтирные модели остаются двигателем исследований и по сути капитальными расходами, открытые становятся операционными. Данных и бенчмарков, на которых построены соотношения цен, в пересказе The Register нет, так что 90% остаются прогнозом, а не замером.
Реакция: миллион просмотров в X и спор о слопе на Hacker News
Доклад разошёлся по соцсетям: пост инвестора Гильермо Флора (GR Angel, Market Fit) к 5 ноября набрал почти миллион просмотров и 7,7 тыс. лайков.
Фронтирные модели становятся исключением, открытые веса — по умолчанию. Это проблема ценообразования для каждой лаборатории, которая идёт на IPO.
Тред на Hacker News собрал 192 балла и 168 комментариев, и он полезнее поста. jacquesm пишет, что его компания сделала то же на куда более слабом железе и больше не думает, можно ли в долгую доверять провайдерам инференса данные: «ответ, по-моему, „абсолютно нет“». kgeist предупреждает об ошибках корректности GLM на больших контекстах из-за багов в самом vLLM и спрашивает, какая у Revolut конфигурация. iLoveOncall возражает против тезиса о снятых лимитах: в Amazon токены не ограничены, и привело это «только к безумному количеству слопа, иллюзии продуктивности». А вопрос corford, что значит «смешанные $0,30», вход, выход или среднее, остался без ответа Revolut.
Подводим итоги
История Revolut и отчёт Gartner сходятся в одном: дорогие модели уходят в роль исключения, а дефолт переезжает на открытые веса, где цена задаётся железом и качеством настройки, а не прайсом вендора. Для команды поменьше тот же маршрут начинается не с 56 B200, а с публичного API GLM-5.3 или Flash-версии с тем же OpenAI-совместимым протоколом и с честного подсчёта цены решённой задачи, а не миллиона токенов: открытые модели могут быть многословнее, и Gartner об этом пишет прямо. Мы уже видели, как Kimi K3.1 Pro подобралась к Claude Opus 5.5 на долю процента, как Apple режет инженерам бюджеты на ИИ вместо того, чтобы снимать лимиты, и как после внедрения ИИ-агентов кода становится на 30% больше, а ревью дольше на 49%. Дальше стоит смотреть на две вещи: опубликует ли Revolut методику замеров lead time и появятся ли независимые повторения расчёта Gartner на открытых данных. Пока 70% остаются внутренним замером одной компании, а 90% прогнозом на 2030 год.
Источники
- https://www.youtube.com/watch?v=Ok6QdZHCcI8
- https://www.theregister.com/ai-and-ml/2026/11/03/open_models_can_do_90_percent_of_agentic_work_at_a_twentieth_of_the_cost_of_a_frontier_llm_gartner/5307132
- https://www.trendingtopics.eu/revolut-glm-open-weight-coding-costs/
- https://finance.biggo.com/news/71888475bad974d6
- https://news.ycombinator.com/item?id=50350004
- https://x.com/guilleflorvs/status/2117379073785696395
- https://docs.z.ai/guides/overview/pricing
- https://platform.claude.com/docs/en/about-claude/pricing
- https://platform.openai.com/docs/pricing
Комментарии